Visuelle CAPTCHAs beruhten auf einer Annahme: Bots können Bilder nicht so lesen wie Menschen. Eine Zeit lang stimmte das ungefähr. Heute nicht mehr. Ein visuelles CAPTCHA zu umgehen, ist inzwischen eine gut dokumentierte, günstige Dienstleistung, die für ein paar Dollar pro tausend Anfragen angeboten wird. Wer eine Website schützt, sollte daher wissen, wie diese Angriffe funktionieren und welcher Schutz noch hält.
Warum visuelle CAPTCHAs leichte Ziele sind
Klassische CAPTCHAs stellen eine visuelle Aufgabe: verzerrten Text lesen, alle Ampeln finden, ein Puzzleteil an die richtige Stelle ziehen. Die Idee war, dass Computer mehrdeutige Bilder nicht zuverlässig deuten können, Menschen aber schon. Wer weiß, wie CAPTCHAs funktionieren, sieht schnell, wo diese Annahme nicht mehr trägt.
Computer-Vision-Modelle schlagen Menschen heute bei vielen Aufgaben der Bildklassifikation, auch bei den Aufgabentypen, die CAPTCHA-Systeme verwenden. Der W3C-Hinweis zur Unzugänglichkeit von CAPTCHAs weist schon seit 2005 auf Probleme mit Zuverlässigkeit und Barrierefreiheit visueller Aufgaben hin, und der Abstand zwischen Mensch und Maschine bei Erkennungsaufgaben ist seitdem nur kleiner geworden.
Ein CAPTCHA, das allein auf Erkennung setzt, lässt sich auf zwei Wegen überwinden: Man automatisiert die Erkennung oder bezahlt einen Menschen dafür. Beides ist längst etabliert.
Wie Bots CAPTCHAs umgehen
Automatisierungs-Frameworks: Selenium, Playwright und Headless-Browser
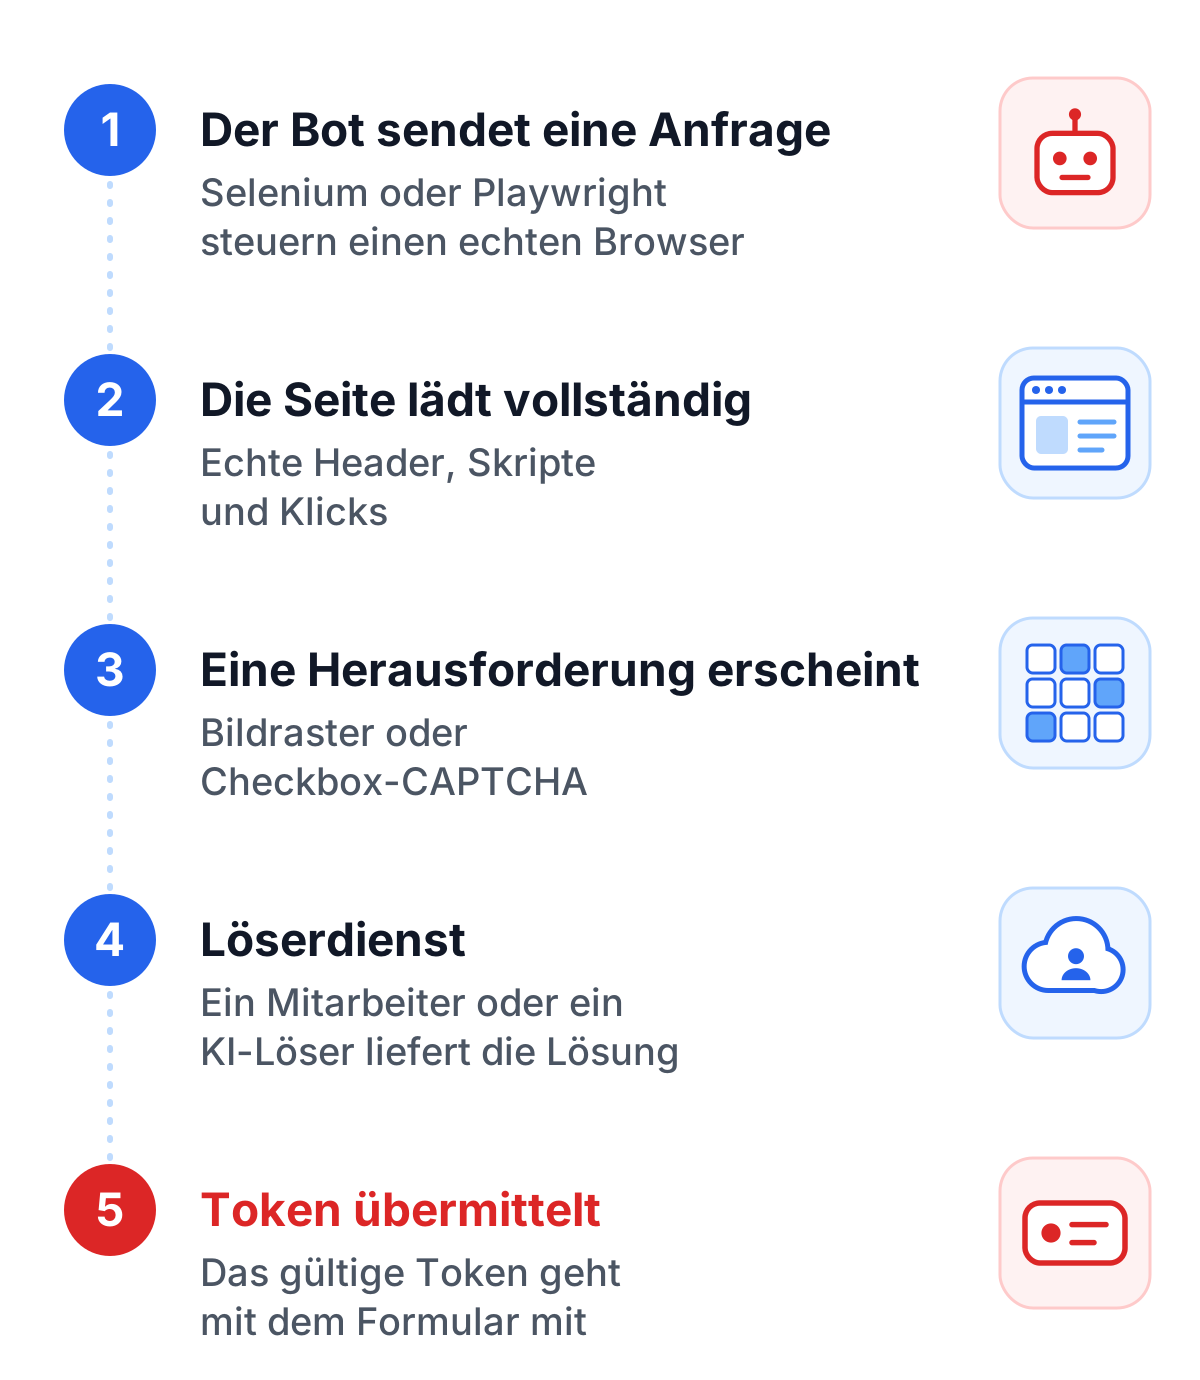
Selenium und Playwright sind Werkzeuge zur Browser-Automatisierung, entwickelt für das Testen von Webanwendungen. Sie steuern echte Browser (Chrome, Firefox, Edge), führen JavaScript aus, verwalten Cookies und bedienen Seitenelemente so, wie es ein Mensch tun würde. Ein Bot auf Basis von Playwright sendet echte Browser-Header, lädt die komplette Seite und löst Klicks dort aus, wo auch ein Nutzer klicken würde.
Ein CAPTCHA, das nur prüft, ob jemand eine Checkbox angeklickt hat, kann einen menschlichen Klick nicht von einem automatisierten unterscheiden. Der Browser ist echt, die Interaktion auch.
Headless-Browser gehen noch einen Schritt weiter. Chrome Headless läuft ohne sichtbares Fenster, ist dadurch schneller und billiger zu skalieren, und Angreifer können Tausende automatisierte Sitzungen parallel auf sehr wenig Infrastruktur betreiben.
CAPTCHA-Lösungsdienste
Kommt die Automatisierung allein mit einer visuellen Aufgabe nicht zurecht, reichen Bots sie an einen Lösungsdienst weiter. Es gibt zwei Hauptmodelle.
Menschlich betriebene Farmen bezahlen Mitarbeiter fürs Lösen von CAPTCHAs. Der Bot gibt die Aufgaben automatisch weiter und bekommt die Antworten innerhalb von Sekunden zurück. Die Preise liegen bei etwa 1 bis 3 USD pro tausend Lösungen. Bei lohnenden Zielen wie Kontoregistrierungen, Ticketkäufen oder Credential Stuffing fallen diese Kosten für den Angreifer kaum ins Gewicht.
KI-basierte Löser sind neuronale Netze, die mit großen Mengen an CAPTCHA-Aufgaben trainiert wurden. Sie laufen lokal, kosten pro Anfrage fast nichts und lösen die meisten Text-CAPTCHAs nahezu fehlerfrei. Bei Bildaufgaben hängt das Ergebnis vom Typ ab, doch der Abstand zum Menschen schrumpft bei allen.
Das Wettrüsten bei der Erkennung
Die Schwierigkeit von Bild-CAPTCHAs folgt einem klaren Muster: Die Aufgaben werden schwerer, die Löser besser, und echte Nutzer tragen den Großteil der Reibung. Mathe-CAPTCHAs zeigen das gut. Als sie aufkamen, wirkten sie wie eine vernünftige, einfachere Alternative zu visuellen Aufgaben. Heute löst sie jedes einfache Automatisierungsskript. Komplexere Bildaufgaben halten länger durch, doch jede Version wird irgendwann geknackt, sobald Modelle genug Aufgabendaten gesammelt haben.
Warum Erkennungsaufgaben nicht standhalten
Das Problem ist nicht, dass CAPTCHA-Entwicklern die Ideen fehlen. Erkennung ist schlicht der falsche Test. Jede Aufgabe, die sich genau genug beschreiben lässt, um eine Maschine darauf zu trainieren, wird früher oder später automatisiert, und das gilt für jede visuelle Aufgabe, die je in einem CAPTCHA steckte.
Schwerere Aufgaben lösen das nicht, sie verschaffen nur Zeit. Dafür belasten sie Menschen mit Seh- oder kognitiven Einschränkungen spürbar, während Bot-Betreiber einfach auf das nächste Modell warten.
Rate Limiting und IP-Sperren helfen am Rand. Bots, die über Playwright im menschlichen Tempo arbeiten, bleiben unter einfachen Ratenlimits, und größere Operationen wechseln ihre IP-Adressen über Residential-Proxy-Netze. Solche Maßnahmen senken das Volumen eines Angriffs, sagen aber nichts über die Absicht hinter einer Anfrage.
Was wirklich funktioniert: Schutz in mehreren Schichten
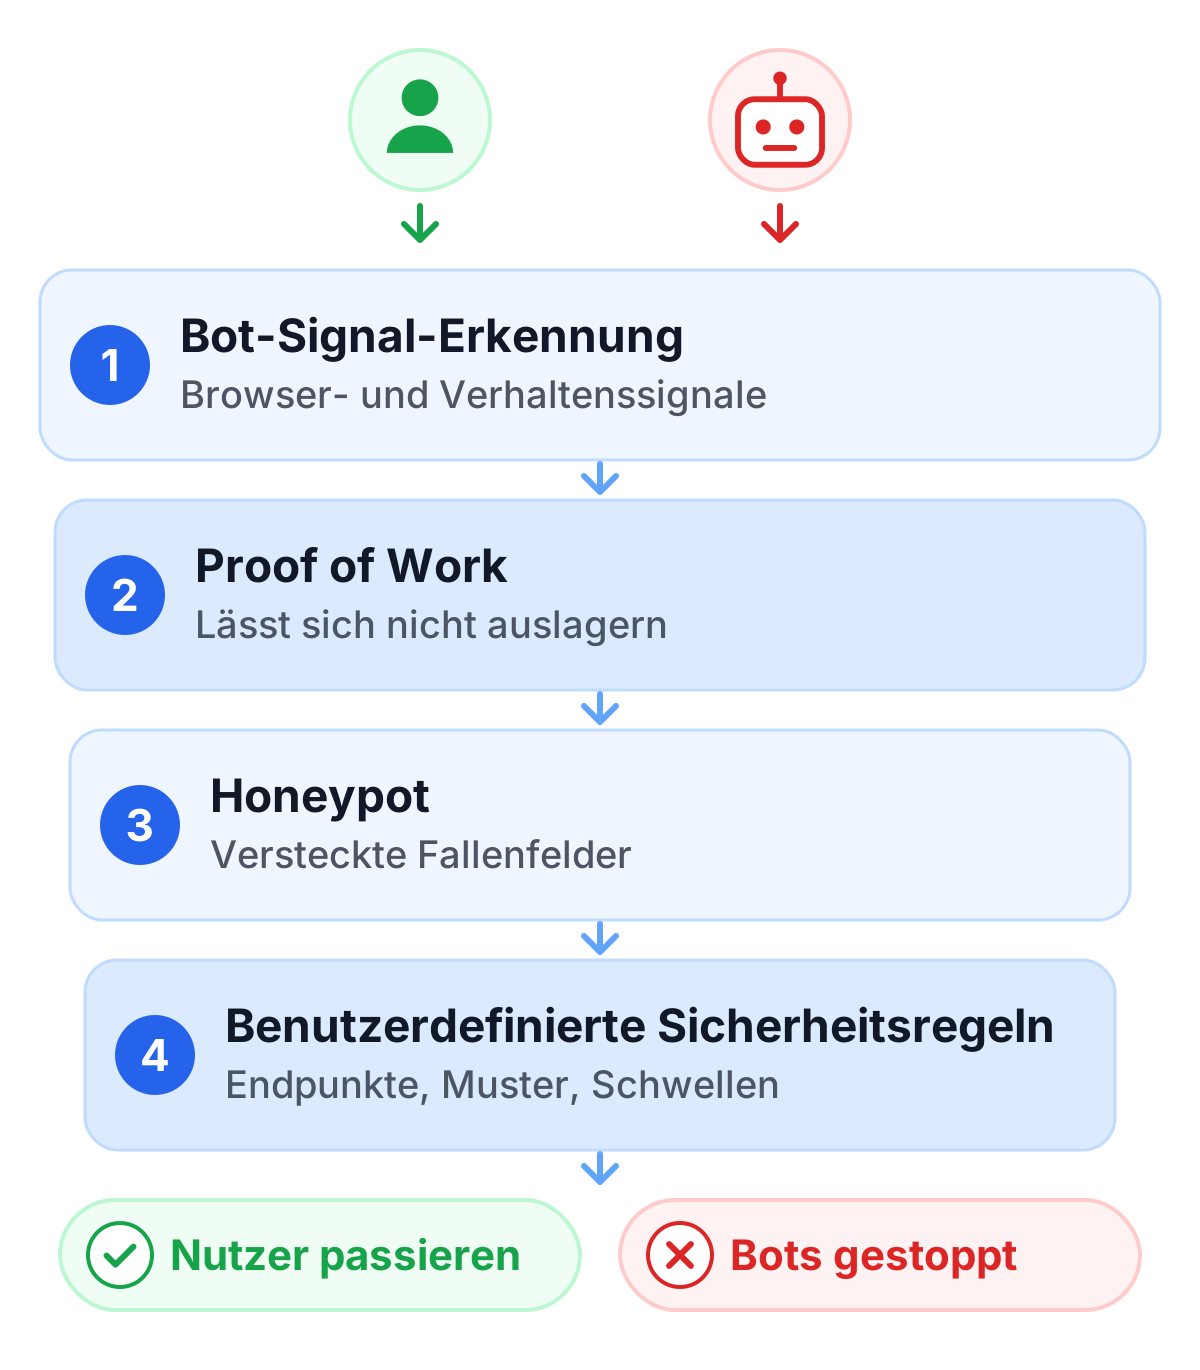
Schutz, der modernen Umgehungsversuchen standhält, ersetzt nicht einen Erkennungstest durch einen schwereren. Er ergänzt eine Schicht, die überhaupt nicht von Erkennung abhängt.
Bot-Signal-Erkennung
Bot-Erkennung auf Basis von Browser- und Verhaltenssignalen erkennt automatisierten Traffic in vielen Fällen. Systeme, die aus diesen Signalen einen Bot-Score berechnen, können verdächtige Anfragen markieren, bevor überhaupt eine Aufgabe angezeigt wird.
Diese Schicht stoppt bereits einen großen Teil der Bots und des Spams. Anspruchsvollere Operationen sind aber gezielt darauf gebaut, an signalbasierter Erkennung vorbeizukommen. Deshalb braucht es eine zweite Schicht.
Proof-of-Work: die Schicht, die sich nicht auslagern lässt
Proof-of-Work lässt den Browser etwas berechnen, statt etwas erkennen. Die Aufgabe ist kryptografisch: eine Hash-Berechnung, die echte Rechenzeit kostet. Der Browser eines echten Nutzers erledigt sie im Hintergrund, während der Nutzer weitermacht.
Für eine einzelne Anfrage sind die Kosten vernachlässigbar. Für einen Bot-Betrieb mit Tausenden gleichzeitigen Sitzungen summiert sich die Rechenarbeit. Anders als Bilderkennung lässt sie sich nicht an eine menschliche Lösungsfarm abgeben, denn Menschen können keine Hashes von Hand berechnen, das können nur Maschinen. Und anders als bei KI-Bildlösern gibt es keine Abkürzung durch Training. Die Arbeit muss erledigt werden.
Steigen die Risikosignale, steigt die Proof-of-Work-Schwierigkeit automatisch mit. Traffic mit geringem Risiko kommt schnell durch, verdächtiger Traffic bekommt eine schwerere Aufgabe. Echte Nutzer werden nicht unterbrochen, weil die Berechnung läuft, während sie das Formular ausfüllen.
Genau das unterscheidet Proof-of-Work von erkennungsbasierten Ansätzen: Die Kosten des Angreifers wachsen mit der Größe des Angriffs. Bild-CAPTCHAs werden mit jedem besseren Modell billiger zu umgehen. Proof-of-Work nicht.
TrustCaptcha: Schichten, die zusammenarbeiten
TrustCaptcha führt beide Mechanismen nacheinander aus. Jede Anfrage wird anhand von Browser- und Verhaltenssignalen bewertet. Für echte Nutzer läuft die Proof-of-Work-Aufgabe im Hintergrund. Bei Anfragen mit höheren Risikosignalen steigt die Schwierigkeit automatisch.
Es gibt kein Bild, das sich an eine Lösungsfarm weiterreichen ließe, und keine Checkbox, die ein Playwright-Skript anklicken könnte. Die Bot-Erkennungsfunktionen übernehmen den ersten Filter, Proof-of-Work den Rest. Ein Bot, der eine Schicht umgeht, trifft trotzdem auf die andere.
Zusätzlich ergänzt TrustCaptcha einen Honeypot und unterstützt eigene Sicherheitsregeln. Damit legen Website-Betreiber konkrete Bedingungen fest, die zusätzliche Maßnahmen auslösen. Regeln können an Bedingungen wie IP-Adresse, Land, Sprache, Zeitzone, Browser, Betriebssystem oder Gerät anknüpfen. So steuern Teams, wie sich der Schutz in ihrer eigenen Umgebung verhält, statt sich allein auf das automatische Scoring zu verlassen.
Für Websites, die CAPTCHA-Alternativen ohne Google-Abhängigkeit und DSGVO-Risiken suchen, läuft TrustCaptcha in EU-Rechenzentren und setzt keine Cookies. Ein Auftragsverarbeitungsvertrag (AVV) ist in jedem Plan enthalten, ohne separate rechtliche Verhandlungen.
Kurz gesagt
- Visuelle CAPTCHAs lassen sich zuverlässig mit Browser-Automatisierung wie Selenium oder Playwright umgehen oder über CAPTCHA-Lösungsdienste, die weniger als 3 USD pro tausend Aufgaben kosten.
- Schwerere Bildaufgaben treffen vor allem echte Nutzer. Sie lösen nicht das eigentliche Problem, dass sich Erkennungsaufgaben automatisieren lassen.
- Bot-Signal-Erkennung stoppt bereits einen großen Teil der Bots und des Spams. Anspruchsvollere Operationen sind darauf gebaut, an ihr vorbeizukommen, deshalb braucht es eine zweite Schicht.
- Proof-of-Work ist die Schicht, die hält, wenn die Erkennung versagt. Es verlangt echte Rechenarbeit, die sich weder an Menschen auslagern noch durch KI beschleunigen lässt.
- Ein CAPTCHA wie TrustCaptcha, das Bot-Signal-Erkennung, Proof-of-Work und eigene Sicherheitsregeln kombiniert, macht Umgehungsversuche teuer und leichter erkennbar. Ob ein Angriff auf Automatisierung, Lösungsdienste oder fortgeschrittene Tarnung setzt, mindestens eine Schicht greift.
TrustCaptcha kostenlos testen
Deine Nutzer sollten keine Rätsel lösen müssen, um zu beweisen, dass sie Menschen sind, und du solltest dich nicht zwischen einer reibungslosen Nutzererfahrung und zuverlässigem Schutz entscheiden müssen. Teste TrustCaptcha 14 Tage kostenlos: Verifizierung ohne Rätsel, die läuft, während deine Nutzer das Formular ausfüllen, und Bot-Schutz, der modernen Umgehungsversuchen standhält.