Was ist Bot-Erkennung?
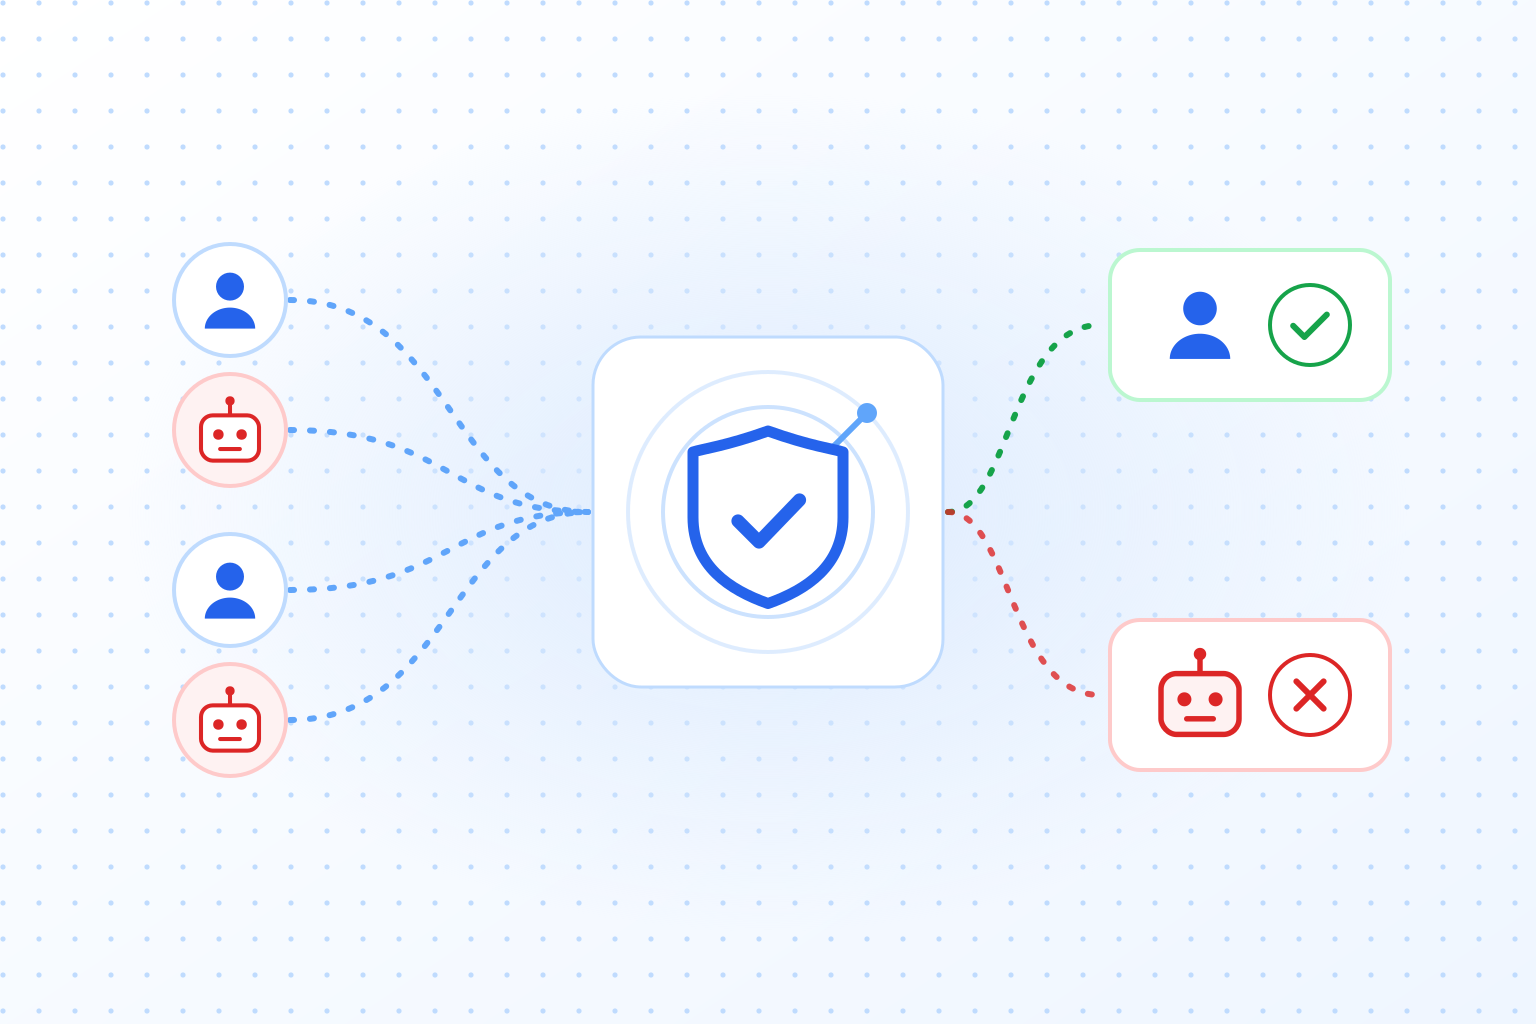
Bot-Erkennung entscheidet, ob eine Anfrage von einem Menschen oder von einem Programm stammt. Sie prüft, wie die Anfrage aufgebaut ist, wie sich die Sitzung verhält und in welcher Umgebung sie läuft, und macht aus diesen Signalen eine Entscheidung: zulassen, erneut prüfen oder blockieren.
Bot-Traffic erreicht fast jeden Teil eines modernen Produkts: Kontoerstellung, Login, Checkout, Suche, Preisseiten, Inhalte und APIs. Ein Teil davon ist nützlich und gewollt. Ärger beginnt, wenn Bots deine Regeln ignorieren und nach Schwachstellen suchen, Inhalte kopieren, Interaktionen vortäuschen oder Ressourcen verbrauchen. Deshalb lohnt es sich, Bot-Traffic als dauerhaftes Betriebsrisiko zu behandeln und nicht als einmaliges Aufräumen.
Gute Bot-Erkennung erkennt diesen Traffic sicher und stoppt ihn, ohne die Nutzererfahrung zu verschlechtern. TrustCaptcha, ein unsichtbares CAPTCHA, bei dem Besucher nichts tun müssen, ist für Teams gebaut, die diesen Schutz ohne Rätsel, Unterbrechungen oder verlorene Conversions wollen.
Was ist Bot-Traffic?
Bot-Traffic ist jeder nicht menschliche Traffic auf einer Website, in einer App oder an einer API. Oft steht der Begriff einfach für “schlechte Aktivität”, die Lage ist aber gemischter. Automatisierte Programme helfen deinem Geschäft, wenn sie sich zu erkennen geben, vorhersehbar verhalten und in vernünftigen Grenzen bleiben. Dieselbe Automatisierung schadet, wenn sie sich versteckt, in großen Mengen läuft oder Ergebnisse manipulieren soll.
Zum Sicherheits- und Stabilitätsproblem wird Bot-Traffic, wenn er Aktionen trifft, die Wert haben: Anmeldung, Transaktionen, Reservierungen von Ware, Zugriff auf Inhalte oder Abläufe, die bei jedem Durchlauf Geld kosten (E-Mails, SMS, Rechenzeit, kostenpflichtige APIs von Drittanbietern). Angreifer suchen sich, was sich billig skalieren lässt und sich messbar auszahlt. Das kann Diebstahl sein, abgegriffene Daten oder schlicht Störung.
Gute Bots, Grauzonen-Bots und bösartige Bots
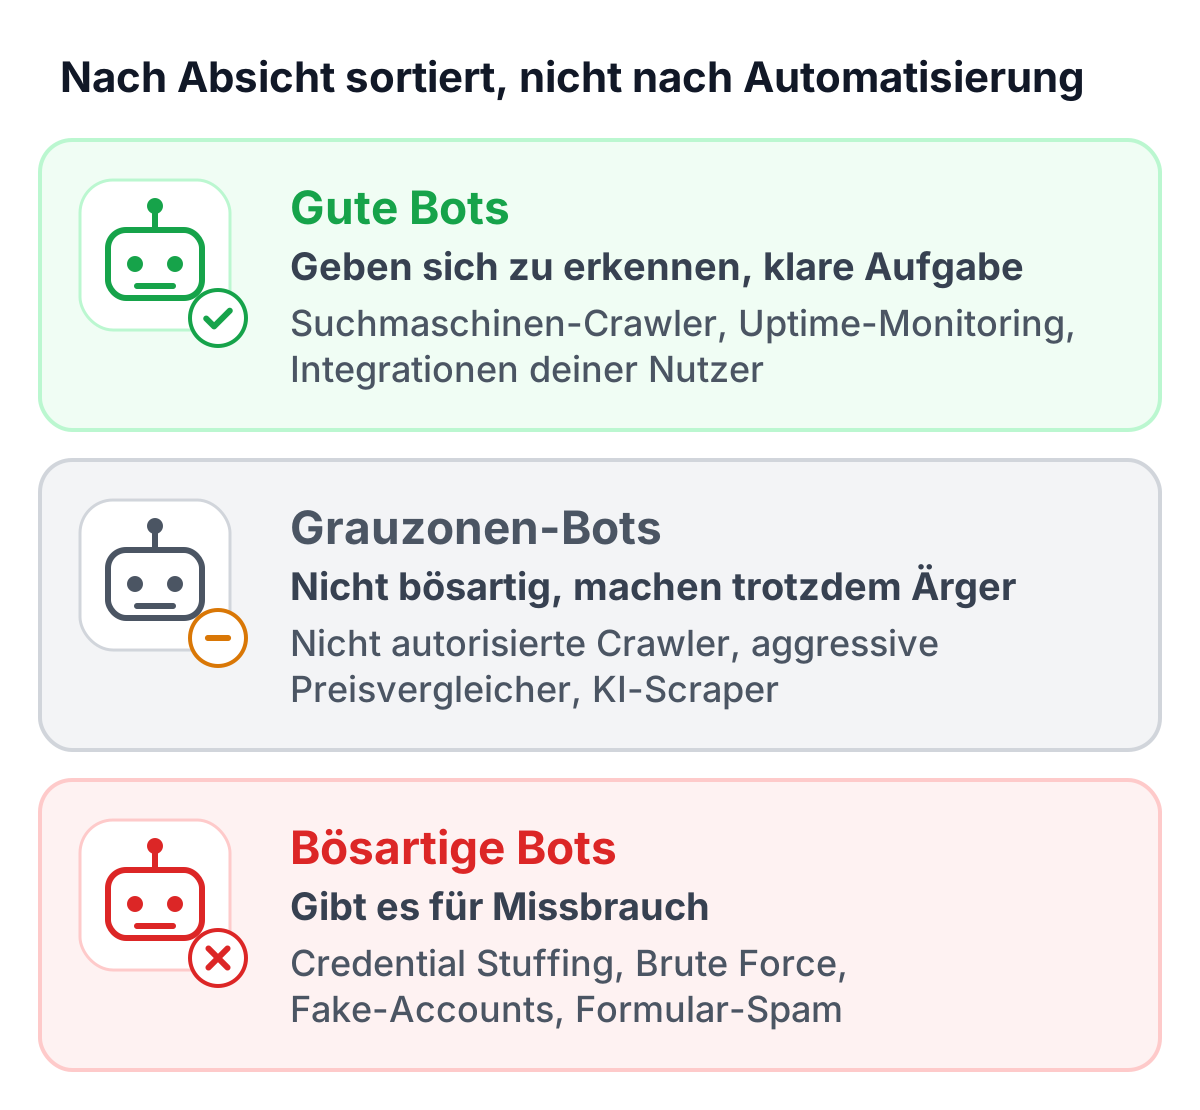
Nicht jeder Bot gehört blockiert. Sinnvoll ist eine Einteilung nach Absicht und danach, ob sich ein Bot an deine Regeln hält, nicht danach, ob er automatisiert ist.
Gute Bots geben sich meist zu erkennen und erledigen eine klare Aufgabe. Dazu gehören Crawler von Suchmaschinen, Uptime-Monitoring und Integrationen, auf die sich deine Nutzer verlassen. Sie sind willkommen, solange du prüfen kannst, wer sie sind und was sie tun.
Grauzonen-Bots sind nicht unbedingt bösartig, machen aber trotzdem Ärger. Gemeint sind nicht autorisierte Crawler, aggressive Preisvergleicher oder KI-Scraper, die Crawl-Regeln ignorieren und deine Kosten treiben. Sie verfälschen Statistiken und Performance-Werte. Außerdem können sie deine Server so stark belasten, dass Rate Limits greifen, die dann echte Nutzer treffen.
Bösartige Bots gibt es für Missbrauch. Typisch sind Credential Stuffing (gestohlene Zugangsdaten durchprobieren), Brute-Force-Logins, Fake-Account-Erstellung, Formular-Spam, Klickbetrug bei Anzeigen, Scraping in großem Stil, das Horten von Warenkörben und Lagerbestand sowie Denial-of-Service-Traffic. Angreifer nutzen sie auch, um nach Schwachstellen zu suchen und deine Abwehr zu kartieren.
Es geht also nicht darum, jede Automatisierung zu stoppen. Es geht darum, dass Vertrauen über den Zugang zu sensiblen Abläufen entscheidet: Wer interagiert, wie verhält er sich, und kann man ihn vernünftigerweise als legitimen Nutzer behandeln?
Warum Bot-Traffic ein Geschäftsrisiko ist
Bot-Traffic wird oft als technisches Ärgernis abgetan. Der geschäftliche Schaden ist aber konkret, und er summiert sich. Sobald Bots dein Produkt erreichen, richten sie in mindestens vier Bereichen Schaden an.
Erstens verzerren Bots Entscheidungen. Bei aufgeblähtem Traffic zeigen deine Statistiken nicht mehr, was Nutzer wirklich wollen. Produktänderungen wirken aus den falschen Gründen erfolgreich oder erfolglos, A/B-Tests verlieren ihre statistische Aussagekraft, und Funnel-Analysen werden unzuverlässig. Am Ende optimieren Teams gegen Rauschen.
Zweitens kosten Bots direkt Geld. Automatisierte Anfragen verbrauchen Bandbreite, Server- und Datenbankkapazität sowie Kontingente bei Drittanbietern. Selbst harmloses Scraping kann teures Rendering und Cache-Fehlgriffe auslösen. Für ein Startup kann das richtig wehtun; bei einer großen Plattform verschiebt es immer noch die Kosten pro Nutzer und die Kapazitätsplanung.
Drittens kosten Bots Vertrauen. Spam-Konten senken die Qualität einer Community, gefälschte Registrierungen verunreinigen CRM-Daten, und automatisierte Betrugsversuche erzeugen Arbeit im Support. Wenn echte Nutzer auf Sperren, Sicherheitswarnungen oder langsame Seiten stoßen, verlieren sie das Vertrauen in das Produkt.
Viertens ermöglichen Bots Betrug. Credential Stuffing macht aus wiederverwendeten Passwörtern übernommene Konten. Gehortete Ware lässt echte Kunden vor ausverkauften Produkten stehen. Automatisierte Checkout-Versuche und Kartentests machen deine Plattform zum Werkzeug für Angreifer und ziehen dich in Streitfälle, Rückbuchungen und Rufschäden.
Bot-Abwehr ist deshalb kein einzelnes Feature. Sie gehört dazu, wenn du einen Dienst betreibst, dem Menschen vertrauen, egal in welcher Größe.
Wie du Bots erkennst
Bot-Erkennung entscheidet, ob eine Interaktion eher von einem Menschen oder von einer Maschine kommt. Gute Lösungen kombinieren mehrere Ebenen: Beobachtung am Netzwerkrand, Verhaltensanalyse im Browser oder in der App und Durchsetzung an sensiblen Endpunkten. Kein einzelnes Signal reicht, weil Angreifer sich anpassen. Du brauchst eine Einordnung, die auch dann noch stimmt, wenn jemand gezielt versucht, sie zu täuschen.
Einfache Automatisierung fällt in den Logs oft sofort auf: Anfragen nach einem starren Muster, Timing, das kein Mensch schafft, verdächtige User Agents oder Schübe von wenigen IP-Adressen. Moderne Automatisierung wechselt aber IP-Adressen, fälscht Header und nutzt Headless-Browser, um echt zu wirken. Um Bots zu erkennen, brauchst du deshalb auch Signale auf höherer Ebene, die sich nur schwer dauerhaft fälschen lassen.
Web-Analytics warnen früh, sind aber kein Sicherheitswerkzeug. Sie zeigen Auffälligkeiten, denen du nachgehen und auf die du deine Abwehr einstellen solltest.
Auffälligkeiten in Analytics, die oft auf Bots hindeuten
Ein plötzlicher Anstieg der Seitenaufrufe, zu dem keine Kampagne, kein Launch und keine Erwähnung in der Presse passt, ist ein häufiges Warnsignal. Dasselbe gilt für seltsame Absprungraten, entweder extrem hoch (eine Seite, dann weg) oder verdächtig niedrig (perfekte Abfolgen über viele Seiten), die auf skriptgesteuertes Surfen hindeuten können.
Die Sitzungsdauer verrät Bots in beide Richtungen. Manche sind zu schnell und klicken in einem Tempo durch, das kein Mensch erreicht. Andere bremsen absichtlich, um nicht aufzufallen, und erzeugen damit Sitzungen, die lang und merkwürdig gleichförmig sind. Schau auf die Verteilung und nicht nur auf den Durchschnitt: Menschliches Verhalten ist unordentlich, Skripte bilden Häufungen.
Müll-Conversions sind ein weiteres Zeichen. Formulare mit erfundenen Namen, auffälligen E-Mail-Mustern, unmöglichen Telefonnummern oder immer demselben Textbaustein stammen meist von Automatisierung. Bei der Kontoerstellung ist eine hohe Zahl von Registrierungen aus einer Region, einem Netz (ASN) oder mit einem Geräteprofil ein deutliches Warnsignal, vor allem wenn du diese Region gar nicht bedienst.
Keines dieser Signale beweist für sich allein Bot-Aktivität. Sie zeigen dir aber, wo du genauer protokollieren, wo du eingreifen und wo sich stärkere Kontrollen lohnen.
Warum Filtern in Analytics nicht dasselbe ist wie Bots stoppen
Viele Teams fangen damit an, bekannte Bots aus ihren Analytics herauszufiltern, und das ist vernünftige Hygiene. Es entfernt Rauschen durch bekannte Crawler aus den Berichten. Deine Systeme schützt es aber nicht. Der Traffic erreicht weiterhin deine Server, löst weiterhin Abläufe aus und richtet weiterhin Schaden an. Wenn du Betrug stoppen, die Performance stabil halten und Nutzer schützen willst, brauchst du Durchsetzung und nicht nur sauberere Berichte.
Kurz gesagt: Filtern verbessert die Messung, Bot-Abwehr verbessert Sicherheit und Stabilität. Du brauchst beides, aber beides löst verschiedene Probleme.
Kerntechniken moderner Bot-Erkennung
Die Techniken der Bot-Erkennung lassen sich in eine Handvoll Gruppen einteilen. Gute Umsetzungen wählen nicht eine davon aus, sondern führen sie zu einer gemeinsamen Entscheidung zusammen.
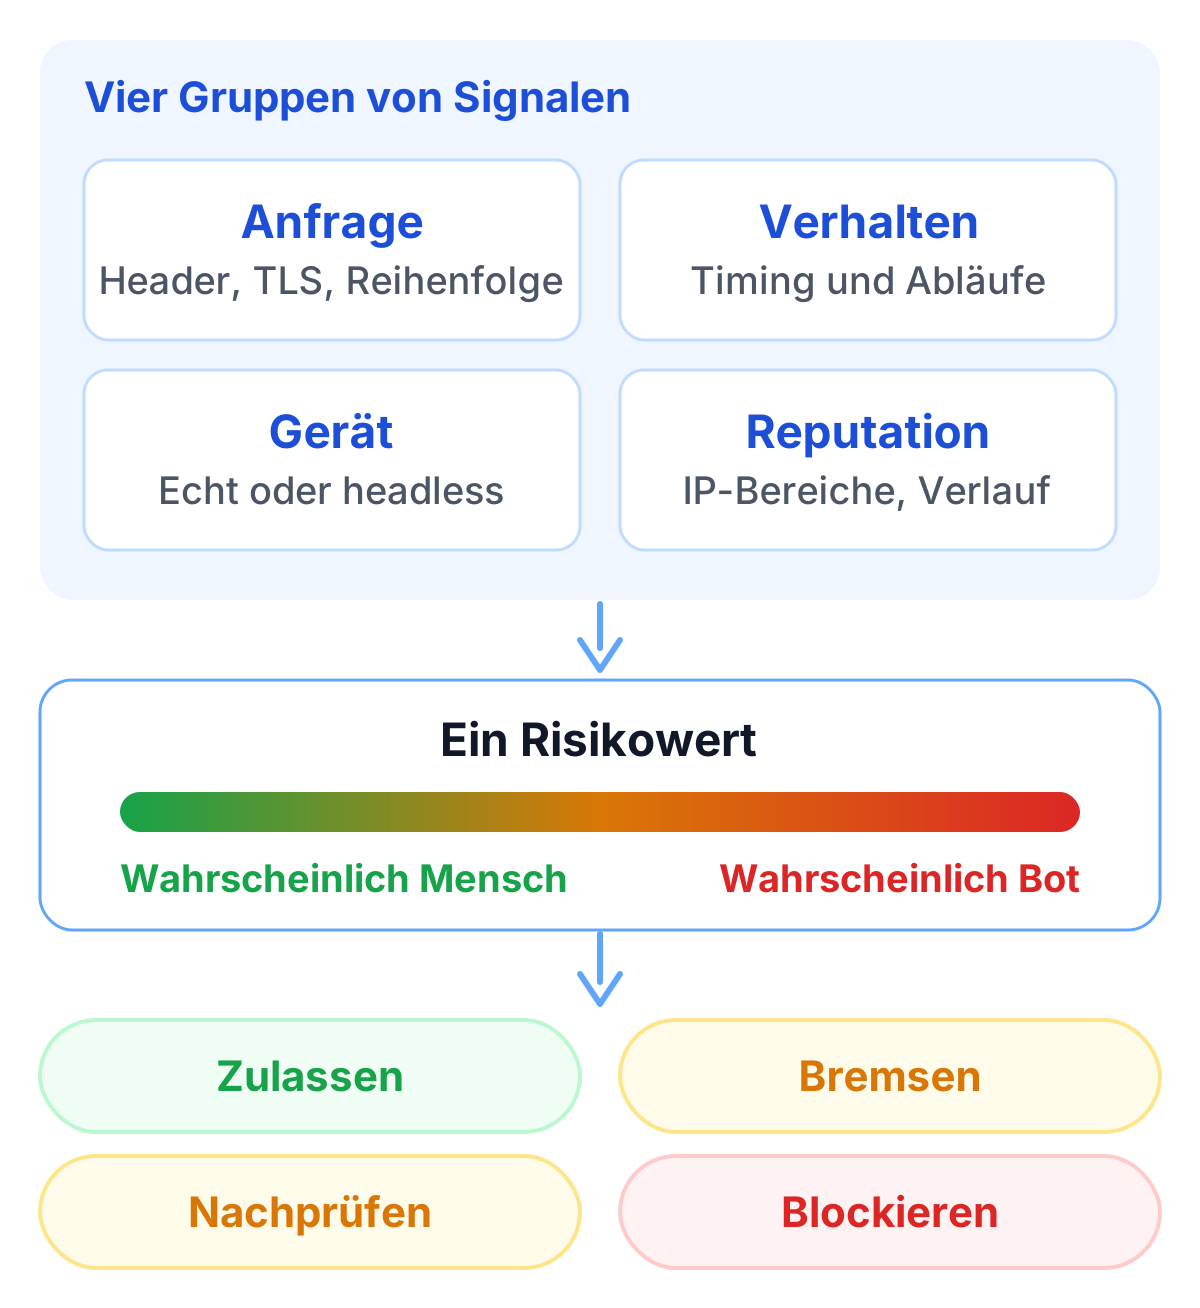
Anfrage- und Protokollanalyse schaut, wie Anfragen aufgebaut sind. Bots machen oft kleine Fehler bei der Zusammensetzung der Header, bei TLS-Fingerprints, bei der Reihenfolge oder bei der Konsistenz über mehrere Anfragen. Selbst ausgefeilte Werkzeuge hinterlassen Muster, die in der Masse sichtbar werden.
Verhaltensanalyse schaut, wie eine Interaktion abläuft. Menschen scrollen ungleichmäßig, zögern, korrigieren Tippfehler und schweifen ab. Bots steuern meist direkt aufs Ziel zu: Sie schicken Formulare mit exaktem Timing ab, folgen perfekten Abfolgen und wiederholen dasselbe Muster in jeder Sitzung. Gute Verhaltensprüfungen stützen sich auf viele kleine Signale statt auf eine einzelne Geste, weil sich viele Signale zusammen kaum überzeugend nachahmen lassen.
Geräte- und Umgebungssignale prüfen, ob die Browserumgebung echt aussieht. Angreifer lassen Automatisierung oft in Headless-Browsern, Emulatoren oder Werkzeugen laufen, die gezielt gegen Erkennung gebaut sind. Wer verteidigt, kann Widersprüche zwischen dem erkennen, was der Browser zu sein behauptet, und dem, wie er sich tatsächlich verhält.
Reputation und Bedrohungsdaten nutzen die Vorgeschichte: bekannte missbräuchliche IP-Bereiche, Rechenzentrumsnetze, Häufungen von Auffälligkeiten und Muster, die auf vielen Websites auftauchen. Das hilft, will aber vorsichtig eingesetzt werden, sonst blockierst du echte Nutzer, die sich eine Infrastruktur mit Angreifern teilen.
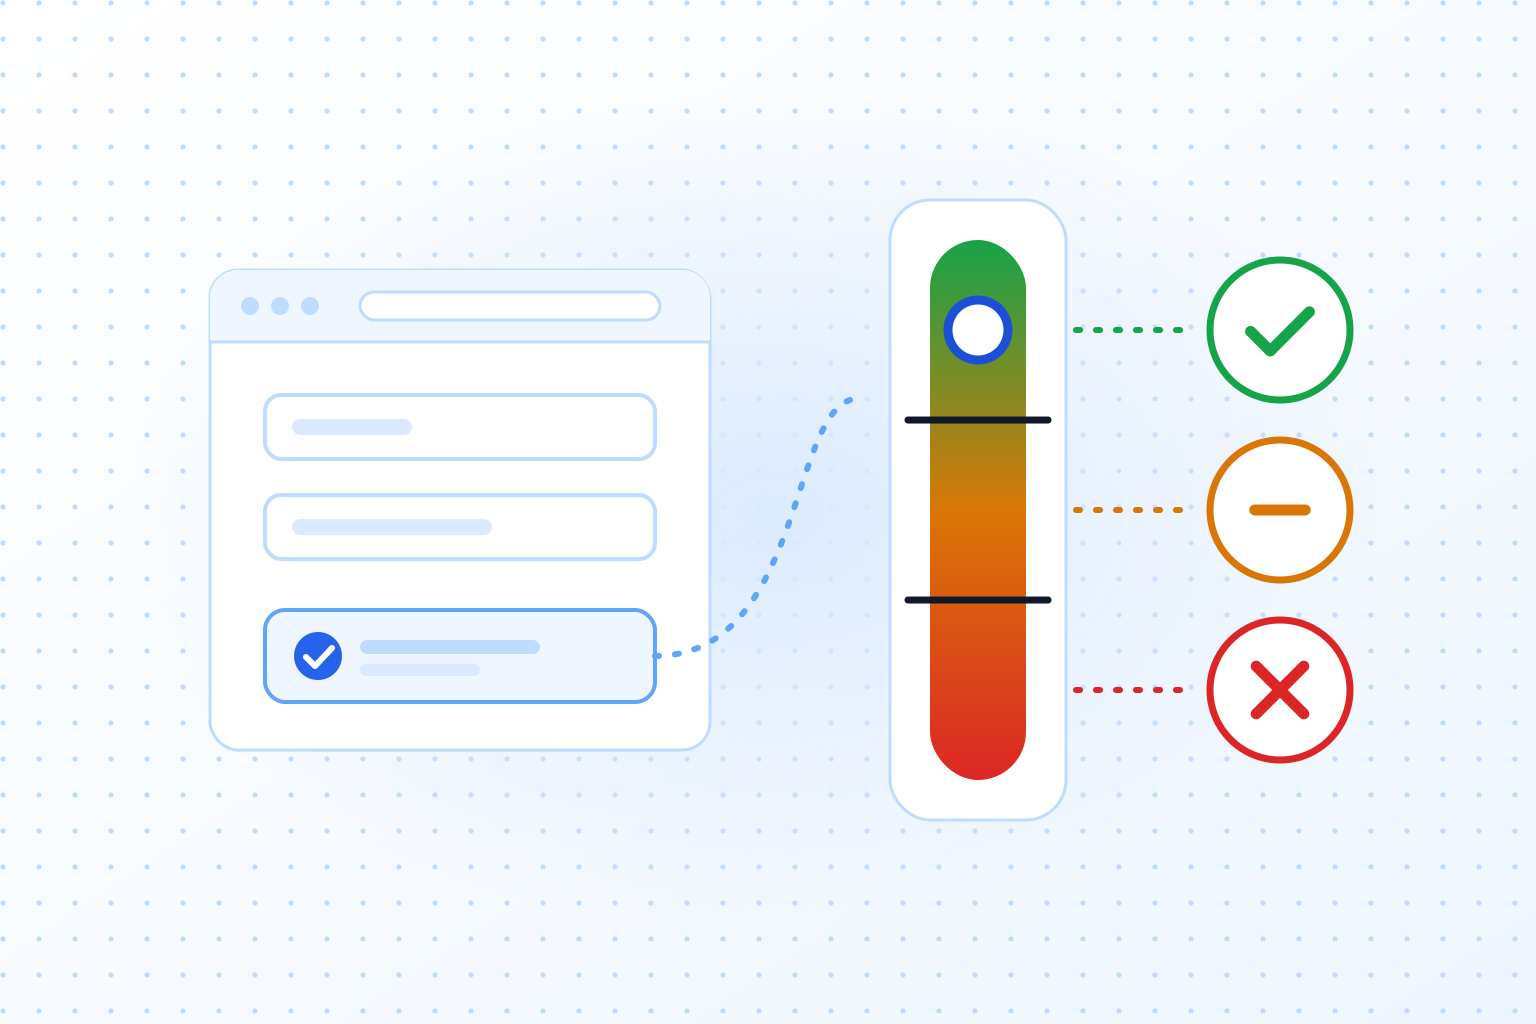
Risikobewertung und abgestufte Durchsetzung machen aus Signalen Entscheidungen. Statt überall hart “blockieren oder zulassen” zu spielen, vergeben ausgereifte Systeme einen Risikowert, oft Bot-Score genannt, und reagieren unterschiedlich, je nachdem, wie wertvoll der Endpunkt ist, in welchem Zustand der Nutzer ist und wie stark der Angriff gerade läuft.
Dahin entwickelt sich das Feld: weniger sichtbare Aufgaben, mehr stille, laufende Bewertung.
Warum klassische CAPTCHAs nicht mehr die erste Wahl sein sollten
Klassische CAPTCHAs wurden für einfachere Bots und kleinere Angriffe gebaut. Heute verursachen ihre Rätsel drei wiederkehrende Probleme.
Rätsel bremsen echte Nutzer. Jeder Schritt, der eine Registrierung oder einen Checkout unterbricht, erhöht die Abbruchquote. Wer Menschen Rätsel lösen lässt, bezahlt Sicherheit mit Umsatz.
Auch Barrierefreiheit und Vertrauen leiden. Menschen mit Behinderungen, mit schwacher Mobilverbindung oder auf eingeschränkten Geräten kommen mit Rätseln oft schlecht oder gar nicht zurecht. Das wird zum Compliance-Problem und schadet der Marke.
Und die Rätsel lassen sich immer leichter lösen. Angreifer schicken Rätsel an Klickfarmen, setzen Löser mit maschinellem Lernen ein oder geben sie an bezahlte menschliche Helfer in automatisierten Abläufen weiter. Am Ende belasten Puzzle-CAPTCHAs deine echten Nutzer, während entschlossene Angreifer trotzdem durchkommen.
Ein moderner Ansatz behält die Sicherheit und gibt den Nutzern ihre Zeit zurück.
Bot-Traffic stoppen: eine Strategie in Schichten
Bot-Traffic stoppst du am besten in Schichten. Jede Schicht erhöht die Kosten für den Angreifer, senkt die Erfolgsquote der Automatisierung und gibt dir mehr Kontrolle über die Nutzererfahrung.
Schicht 1: Angriffsfläche verkleinern. Schütze nur, was Schutz braucht, das dann aber richtig. Setze die Abwehr an Endpunkte, die Wert haben: Anmeldung, Registrierung, Passwort-Reset, Checkout und jedes Formular, das teuer ist oder Missbrauch anzieht.
Schicht 2: Rate Limits und Missbrauchskontrollen. Rate Limits, Kontingente pro Anfrage und Schwellenwerte für Auffälligkeiten dämpfen Angriffe mit hohem Volumen. Gegen einfache Bots wirken sie gut, allein reichen sie aber selten, weil geschickte Angreifer ihren Traffic verteilen.
Schicht 3: Verifikation. Hier zeigt eine Prüfung ohne Rätsel ihren Wert: Sie muss Menschen von Automatisierung trennen, mit wenig Reibung und so, dass sie sich schwer umgehen lässt.
Schicht 4: Reaktion und Rückmeldung. Wenn du Traffic blockierst oder erneut prüfst, sollte diese Entscheidung in deine Erkennung zurückfließen, damit du aus jedem Angriff etwas lernst.
Gut umgesetzt senken mehrere Schichten sowohl Fehlalarme als auch den Aufwand im Alltag.
Wo TrustCaptcha bei der Bot-Erkennung hilft
TrustCaptcha ist für Teams gebaut, die starken Bot-Schutz brauchen, ohne Rätsel, Unterbrechungen oder “Beweise, dass du ein Mensch bist”-Momente. Es läuft im Hintergrund und berechnet eine Risikobewertung aus technischen und verhaltensbasierten Signalen, statt den Nutzer etwas tun zu lassen.
Nutzer bemerken die Prüfung nicht, und genau darum geht es. Echte Nutzer schließen ihren Vorgang ohne Ablenkung ab, während automatisierter Missbrauch auf eine deutlich höhere Hürde trifft. Die Arbeit wandert vom Nutzer zum Angreifer.
Am stärksten merkst du den Unterschied dort, wo Conversions zählen. Login, Registrierung, Passwort-Reset und Checkout vertragen kaum Reibung. Eine Prüfung, die die Conversion nicht beschädigt und trotzdem Automatisierung stoppt, bleibt eingeschaltet. Eine Prüfung, die Registrierungen kostet, wird jedes Quartal intern wieder zur Diskussion gestellt.
Proof-of-Work als zusätzliche Schutzschicht
Bei heftigen Angriffen reicht reine Einordnung nicht immer aus. Wenn Angreifer große Mengen automatisierter Anfragen billig erzeugen können, sollte die Bot-Abwehr Missbrauch auch wirtschaftlich sinnlos machen. Ein bewährter Weg dahin ist eine Proof-of-Work-Schicht (PoW): Bevor eine sensible Aktion angenommen wird, muss der Client eine kleine, begrenzte Rechenaufgabe lösen. Für echte Nutzer läuft das unsichtbar und ist schnell erledigt. Für Bots in großer Zahl wird es teuer, weil der Angreifer die Rechenkosten für jeden einzelnen Versuch trägt.
PoW hilft vor allem gegen Automatisierung mit hoher Frequenz, etwa Credential Stuffing, skriptgesteuerte Formulareinsendungen und Traffic-Schübe, die Ressourcen erschöpfen sollen. Sperrlisten und empfindliche Fingerprints lassen sich umgehen; PoW verändert stattdessen die Kostenkurve des Angreifers. Jede zusätzliche Anfrage hat einen Preis, den kein Wechsel der IP-Adresse und kein gefälschter Header beseitigt. Damit ergänzt PoW Verhaltensanalyse und Risikobewertung gut, gerade wenn Bots verteilt arbeiten und sich keiner einzelnen Quelle zuordnen lassen.
In der Praxis bringt PoW Stabilität. Weniger missbräuchliche Anfragen erreichen teure Abläufe, die Performance bricht bei Bot-Wellen seltener ein, und einen Angriff am Laufen zu halten kostet mehr Aufwand. Gezielt eingesetzt statt als Schranke vor jeder Seite stärkt PoW deine Bot-Abwehr, ohne Nutzern Hindernisse in den Weg zu legen.
Entscheidungen gestalten: zulassen, bremsen, nachprüfen oder blockieren
Gute Bot-Abwehr verlässt sich selten auf eine einzige Reaktion. Die Reaktion sollte zum Risiko und zum Wert des Endpunkts passen.
Interaktionen mit geringem Risiko dürfen durch, während du sie weiter beobachtest. Sitzungen mit mittlerem Risiko kannst du bremsen oder um einen neuen Versuch bitten. Aktionen mit hohem Risiko, etwa wiederholte Anmeldeversuche oder massenhafte Formulareinsendungen, solltest du direkt blockieren. Der Vorteil einer risikobasierten Prüfung: Du kannst streng sein, wo es darauf ankommt, und großzügig bleiben, wo die Nutzererfahrung Vorrang hat.
TrustCaptcha unterstützt dieses Modell, weil es deinen Regeln eine Entscheidungsgrundlage liefert: Dein Server erhält das Ergebnis zusammen mit dem Bot-Score, sodass du kritische Aktionen absichern kannst, während normales Surfen reibungslos bleibt.
Signale, die Angreifer kaum dauerhaft fälschen können
Einen User Agent zu fälschen dauert Sekunden. IP-Adressen lassen sich wechseln. Einfaches Browserverhalten lässt sich nachahmen. Viel schwerer ist es, über die ganze Interaktion hinweg stimmig zu bleiben: beim Timing, bei der Abwechslung in der Navigation, bei der Reihenfolge der Ereignisse und bei einer Umgebung, die zusammenpasst.
Bot-Erkennung wird zuverlässig, wenn du die ganze Sitzung betrachtest und nicht nur einzelne Anfragen. Menschen hinterlassen natürliche Unregelmäßigkeiten: Pausen, Korrekturen, ungerade Wege und Wechsel des Kontexts. Automatisierung erzeugt Gleichförmigkeit. Selbst wenn Angreifer ihr Verhalten zufällig gestalten, wirkt dieser Zufall in der Masse meist künstlich.
Ein moderner, unsichtbarer Ansatz baut auf diesen beständigen Unterschieden auf. Du wirst nicht jeden Bot mit einem einzigen Trick erwischen. Du kannst aber dafür sorgen, dass dauerhafte Automatisierung teuer, unzuverlässig und sichtbar wird.
Schritt für Schritt einführen
Bot-Schutz funktioniert am besten, wenn du ihn misst und nachjustierst. Fang mit den Endpunkten an, die am häufigsten missbraucht werden, und verfolge die Ergebnisse: Erfolgsquoten bei Einsendungen, die Verteilung fehlgeschlagener Logins, verdächtige Sitzungsmuster und was dich Missbrauch an Support-Tickets, Lastspitzen und schlechten Daten kostet.
Setze TrustCaptcha dort ein, wo du die Wirkung schnell messen kannst. In vielen Produkten zahlt sich der Schutz von Registrierung und Passwort-Reset sofort aus: weniger Fake-Konten, weniger Spam, ein saubereres CRM, geringere E-Mail-Kosten und weniger Missbrauch an späteren Stellen.
Danach erweiterst du den Schutz Schritt für Schritt. Ziel ist nicht, so viel wie möglich zu blockieren. Ziel ist, dass echte Nutzer durchkommen und automatisierter Missbrauch zuverlässig scheitert.
Was du während eines Angriffs tun solltest
Wenn ein Bot-Angriff Fahrt aufnimmt, braucht dein Team einen klaren Plan. Alle sollten wissen, welche Kennzahlen eine Eskalation anzeigen und welche Maßnahmen gefahrlos sind.
Verschärfe zuerst die Durchsetzung an den wertvollsten Endpunkten. Senke die Rate Limits für eindeutig missbräuchliche Muster, aber vermeide breite Sperren, die echte Nutzer in geteilten Netzen treffen. Nutze deine Prüfergebnisse, um den Traffic aufzuteilen: Lass vertrauenswürdige Sitzungen durch und halte verdächtige konsequent zurück.
Nach dem Vorfall lohnt sich eine kurze Nachbesprechung, in der es ums Lernen geht: Welche Endpunkte waren das Ziel, welche Regeln haben gewirkt, wo gab es Fehlalarme, und welche Abläufe waren teurer als gedacht? Teams, die mit Bots gut umgehen, nutzen jeden Angriff als Grundlage für die nächste Feinabstimmung.
Erfolg messen
Ein Bot-Schutzprogramm ist erfolgreich, wenn sich die Geschäftsergebnisse verbessern, nicht wenn es eine beeindruckende Zahl an Blockierungen meldet. Gute Kennzahlen sind dauerhaft weniger Müll-Conversions, weniger Spam-Konten, weniger Missbrauch beim Login, eine gleichmäßigere Serverlast und sauberere Analytics. In vielen Organisationen ist das deutlichste Zeichen, dass Teams ihren Zahlen wieder trauen und Experimente durchführen können, ohne sich zu fragen, ob Automatisierung das Ergebnis bestimmt hat.
TrustCaptcha hilft dabei, indem es automatisierten Missbrauch stoppt und die Nutzererfahrung schützt, die diese Zahlen abbilden.
TrustCaptcha testen
Wenn du automatisierten Missbrauch eindämmen willst, ohne deinen Nutzern zusätzliche Schritte abzuverlangen, setze TrustCaptcha dort ein, wo es am meisten zählt: bei Formularen, Registrierung, Login und Checkout. Du bekommst Bot-Erkennung, mit der deine Besucher nie etwas zu tun haben. Dynamischer Proof-of-Work ist in jedem kostenpflichtigen Tarif enthalten, Bot-Erkennung mit Bot-Score ab dem Solo-Tarif.
Jeder Tarif startet mit einer 14-tägigen kostenlosen Testphase, und nicht-kommerzielle Websites nutzen TrustCaptcha kostenlos. Starte deine kostenlose Testphase mit deinen riskantesten Endpunkten und lass echte Nutzer ohne Unterbrechung weitermachen.