

Einleitung: Vorfälle sind normal, klare Kommunikation ist eine Entscheidung
Jedes Team, das Software betreibt, hat Vorfälle. Woran sich Kunden danach erinnern, ist selten der Vorfall selbst, sondern wie er kommuniziert wurde: ob sie schnell davon erfahren haben, ob die Updates klar waren und ob das Team erklärt hat, was es daraus gelernt hat.
Ein Kommunikationsplan für Vorfälle macht diesen Teil planbar. Dieser Ratgeber erklärt, was in den Plan gehört, und gibt dir Vorlagen, die du kopieren und anpassen kannst: für Statusseiten-Updates, IT-Ausfallmeldungen, Kunden-E-Mails und das Post-Mortem.
Was ist ein Kommunikationsplan für Vorfälle?
Ein Kommunikationsplan für Vorfälle (manchmal auch Incident-Response-Kommunikationsplan genannt) legt fest, wie deine Organisation während eines Vorfalls kommuniziert:
- Wer kommuniziert, und wer gibt Meldungen frei
- An wen: Kunden, interne Teams, Management, Partner
- Über welche Kanäle: Statusseite, E-Mails an Abonnenten, Hinweise in der App, interner Chat
- Wie oft: der Update-Rhythmus für jeden Schweregrad
- Was danach passiert: das Post-Mortem und die Nachbereitung
Er ist der Kommunikationsteil deines Incident-Management-Prozesses und funktioniert am besten, wenn er schriftlich festgehalten ist, bevor du ihn brauchst.
Die Bausteine des Plans
Rollen
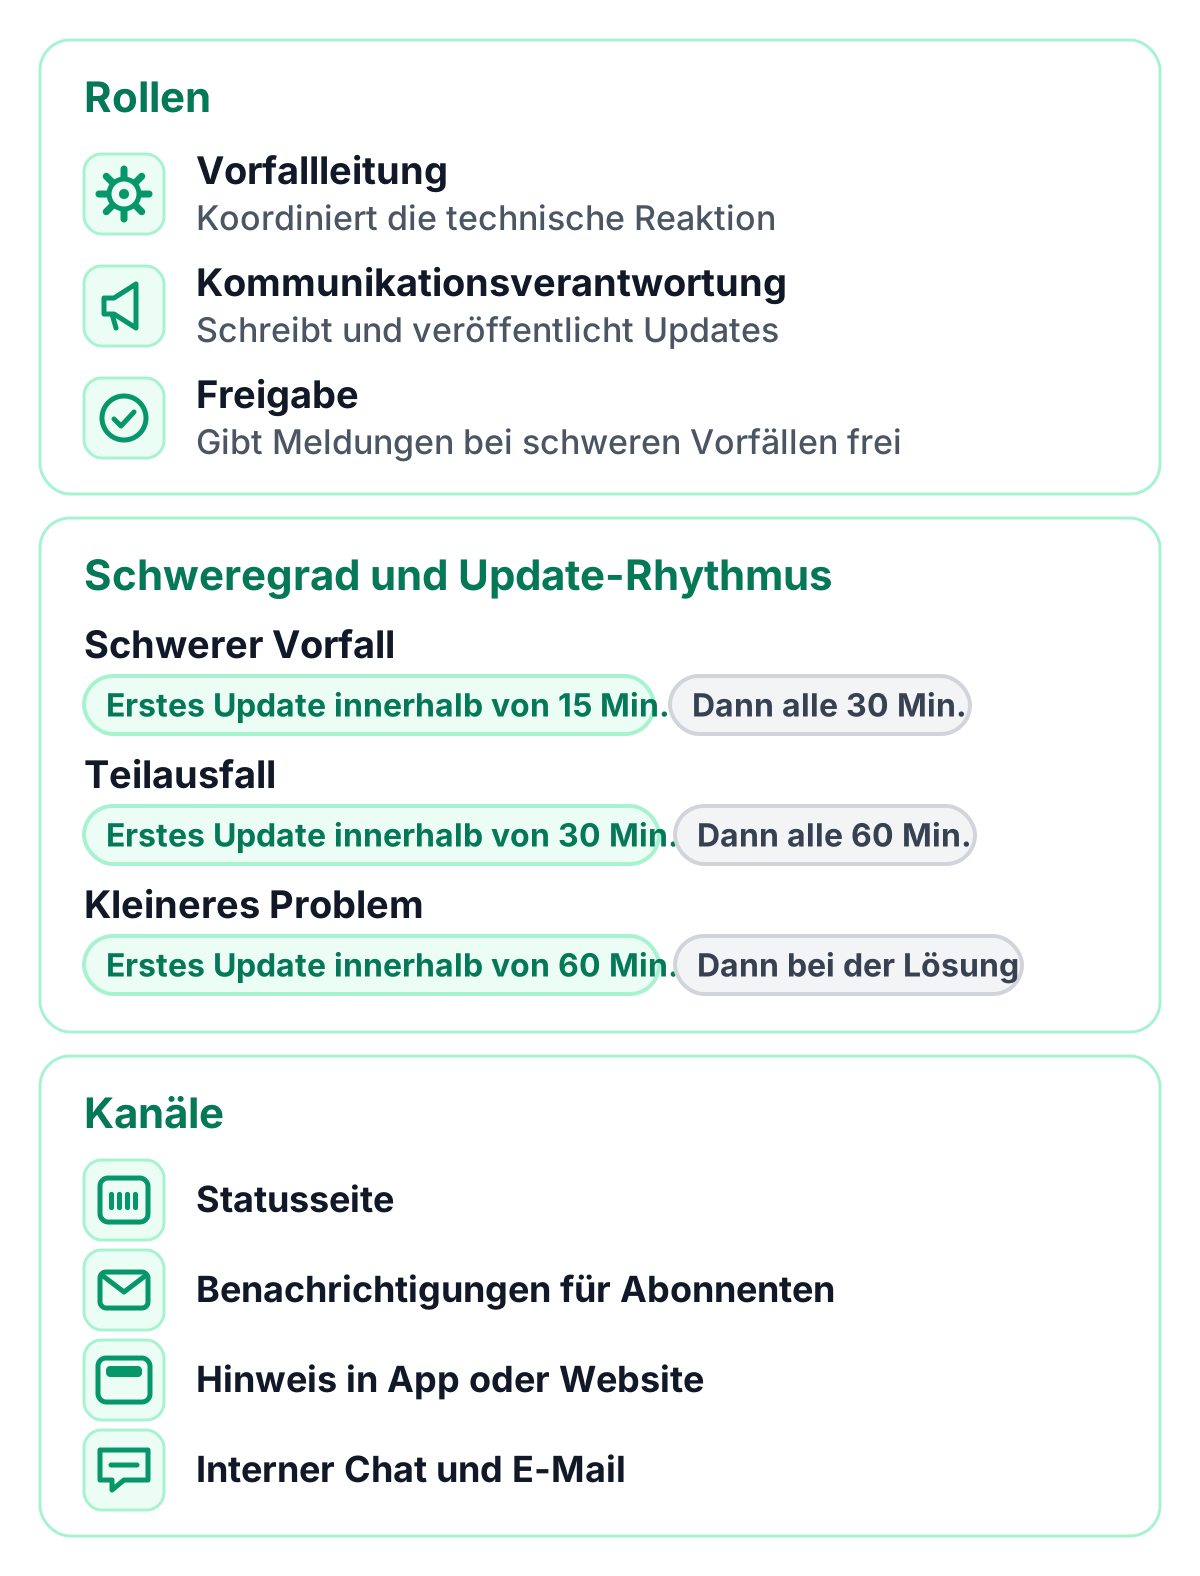
- Vorfallleitung: koordiniert die technische Reaktion.
- Kommunikationsverantwortung: schreibt und veröffentlicht Updates und hält die Zeitleiste aktuell.
- Freigabe: bei schweren Vorfällen eine Person, die kundenrelevante Meldungen freigibt.
Vorfallleitung und Kommunikationsverantwortung zu trennen, ist der wirkungsvollste einzelne Schritt: Updates gehen pünktlich raus, während sich die Engineers auf die Lösung konzentrieren.
Schweregrade und Update-Rhythmus
Lege einige Schweregrade fest und entscheide im Voraus, wie du bei jedem davon kommunizierst. Die Werte unten sind ein üblicher Ausgangspunkt. Passe sie an dein SLA und deine Kunden an:
| Schweregrad | Beispiel | Erstes Update | Weitere Updates |
|---|---|---|---|
| Schwerer Vorfall | Service für die meisten Kunden nicht verfügbar | innerhalb von 15 Minuten | alle 30 Minuten |
| Teilausfall | Eine Funktion oder Region betroffen | innerhalb von 30 Minuten | alle 60 Minuten |
| Kleineres Problem | Beeinträchtigte Performance, Workaround verfügbar | innerhalb von 60 Minuten | bei der Lösung |
| Geplante Wartung | Angekündigte Arbeiten mit erwarteten Auswirkungen | mehrere Tage vorher | zu Beginn und am Ende |
Zur Kommunikation bei schweren Vorfällen gehört auch dein interner Eskalationsweg: wer im Management, im Support und im Vertrieb informiert wird, und wann.
Kanäle
- Statusseite: die zentrale, verlässliche Informationsquelle für Kunden
- Benachrichtigungen für Abonnenten: Updates per E-Mail oder Chat für alle, die abonniert haben
- Hinweis in der App oder auf der Website: ein kurzes Banner mit Link zur Statusseite
- Interner Chat und E-Mail: der Vorfall-Kanal für dein Team und deine Stakeholder
Vorlagen für die Ausfall-Kommunikation
Kopiere diese Vorlagen und ersetze die Platzhalter in eckigen Klammern. Halte jedes Update kurz, sachlich und ruhig.
Statusseite: Untersuchung
Wir untersuchen Meldungen über [Problem] bei [Service oder Funktion].
Einige Nutzer bemerken möglicherweise [Symptom]. Unser Team arbeitet
daran, und das nächste Update folgt bis [Uhrzeit und Zeitzone].
Statusseite: Ursache gefunden
Wir haben die Ursache für [Problem] gefunden und spielen eine Korrektur ein.
[Optional: Workaround.] Nächstes Update bis [Uhrzeit und Zeitzone].
Statusseite: Beobachtung
Eine Korrektur wurde eingespielt, und [Service] erholt sich. Wir beobachten
die Ergebnisse und bestätigen, sobald alles wieder vollständig normal läuft.
Statusseite: Behoben
[Service] ist seit [Uhrzeit und Zeitzone] wieder voll funktionsfähig.
Ursache war [kurze, nicht technische Zusammenfassung]. Wir veröffentlichen
bis [Datum] ein Post-Mortem. Vielen Dank für die Geduld.
Vorlage für IT-Ausfallmeldungen (intern)
Betreff: [Ausfall] [System] seit [Startzeit] nicht verfügbar

Was ist betroffen: [System, Funktion, Standorte]
Wer ist betroffen: [Teams, Kunden, Regionen]
Workaround: [Workaround oder „derzeit keiner“]
Vorfallleitung: [Name], Kommunikation: [Name]
Statusseite: [Link]
Nächstes Update: [Uhrzeit]
Kunden-E-Mail bei einem schweren Vorfall
Betreff: Vorfall bei [Service] am [Datum] — behoben

Hallo [Name],

am [Datum] war [Service] zwischen [Beginn] und [Ende] [Zeitzone] für
[betroffene Kunden] [nicht verfügbar / teilweise nicht verfügbar].
[Was Kunden erlebt haben, in einem Satz.]

Ursache war [kurze Zusammenfassung]. Wir haben das Problem durch
[Maßnahme] behoben. Damit es nicht erneut auftritt, setzen wir
[Verbesserung] um.

Das vollständige Post-Mortem steht hier bereit: [Link]. Bei Fragen
genügt eine Antwort auf diese E-Mail oder eine Nachricht an [Support-Kanal].

[Name], [Team]
Hinweis auf geplante Wartung
Geplante Wartung: Am [Datum] von [Beginn] bis [Ende] [Zeitzone] führen
wir [Beschreibung der Arbeiten] durch. Während dieses Wartungsfensters
ist mit [erwartete Auswirkungen] zu rechnen. Es sind keine Maßnahmen
erforderlich. Wir aktualisieren diesen Hinweis, sobald die Wartung
abgeschlossen ist.
Beispiel für Vorfall-Kommunikation: eine vollständige Zeitleiste
So sieht ein kurzer Vorfall auf einer Statusseite aus, wenn der Plan funktioniert:
| Uhrzeit | Phase | Update |
|---|---|---|
| 08:57 | Untersuchung | Wir sehen erhöhte Antwortzeiten bei der API und untersuchen das. Nächstes Update bis 09:15 Uhr MEZ. |
| 09:02 | Interne Notiz | Datenbank-Connection-Pool erschöpft, Read-Replicas werden skaliert. |
| 09:06 | Behoben | Die Antwortzeiten sind wieder normal. Ein Post-Mortem folgt. |
Die interne Notiz bleibt im Team; Kunden sehen nur die öffentlichen Updates.
Post-Mortem-Vorlage für Vorfälle
Ein Post-Mortem schließt den Vorfall ab. Halte es frei von Schuldzuweisungen: Konzentriere dich darauf, was passiert ist und was du verbessern wirst, und nicht darauf, wer einen Fehler gemacht hat. Diese Post-Mortem-Vorlage deckt das Wesentliche ab:
Post-Mortem zum Vorfall: [Titel]
Datum: [Datum]   Schweregrad: [Stufe]   Verfasst von: [Name]

1. Zusammenfassung
   Was passiert ist, in zwei oder drei Sätzen.

2. Auswirkungen
   Dauer: [Beginn] bis [Ende] ([Gesamtdauer])
   Betroffen: [Services, Kunden, Regionen]
   SLA-Auswirkung: [ja/nein, Details]

3. Zeitleiste (mit Zeitzone)
   [Uhrzeit] Erkannt durch [Monitor / Meldung]
   [Uhrzeit] Vorfall eröffnet, erstes Update veröffentlicht
   [Uhrzeit] Ursache gefunden
   [Uhrzeit] Korrektur ausgerollt
   [Uhrzeit] Behoben und bestätigt

4. Grundursache
   Was den Vorfall verursacht hat und warum er möglich war.

5. Was gut lief
   Erkennung, Reaktion und Kommunikation, die funktioniert haben.

6. Verbesserungen
   [Maßnahme] — verantwortlich: [Name] — fällig: [Datum]
   [Maßnahme] — verantwortlich: [Name] — fällig: [Datum]

7. Rückblick auf die Kommunikation
   Statusseiten-Updates: [Anzahl], Abonnenten benachrichtigt: [ja/nein]
Tools für die Vorfall-Kommunikation
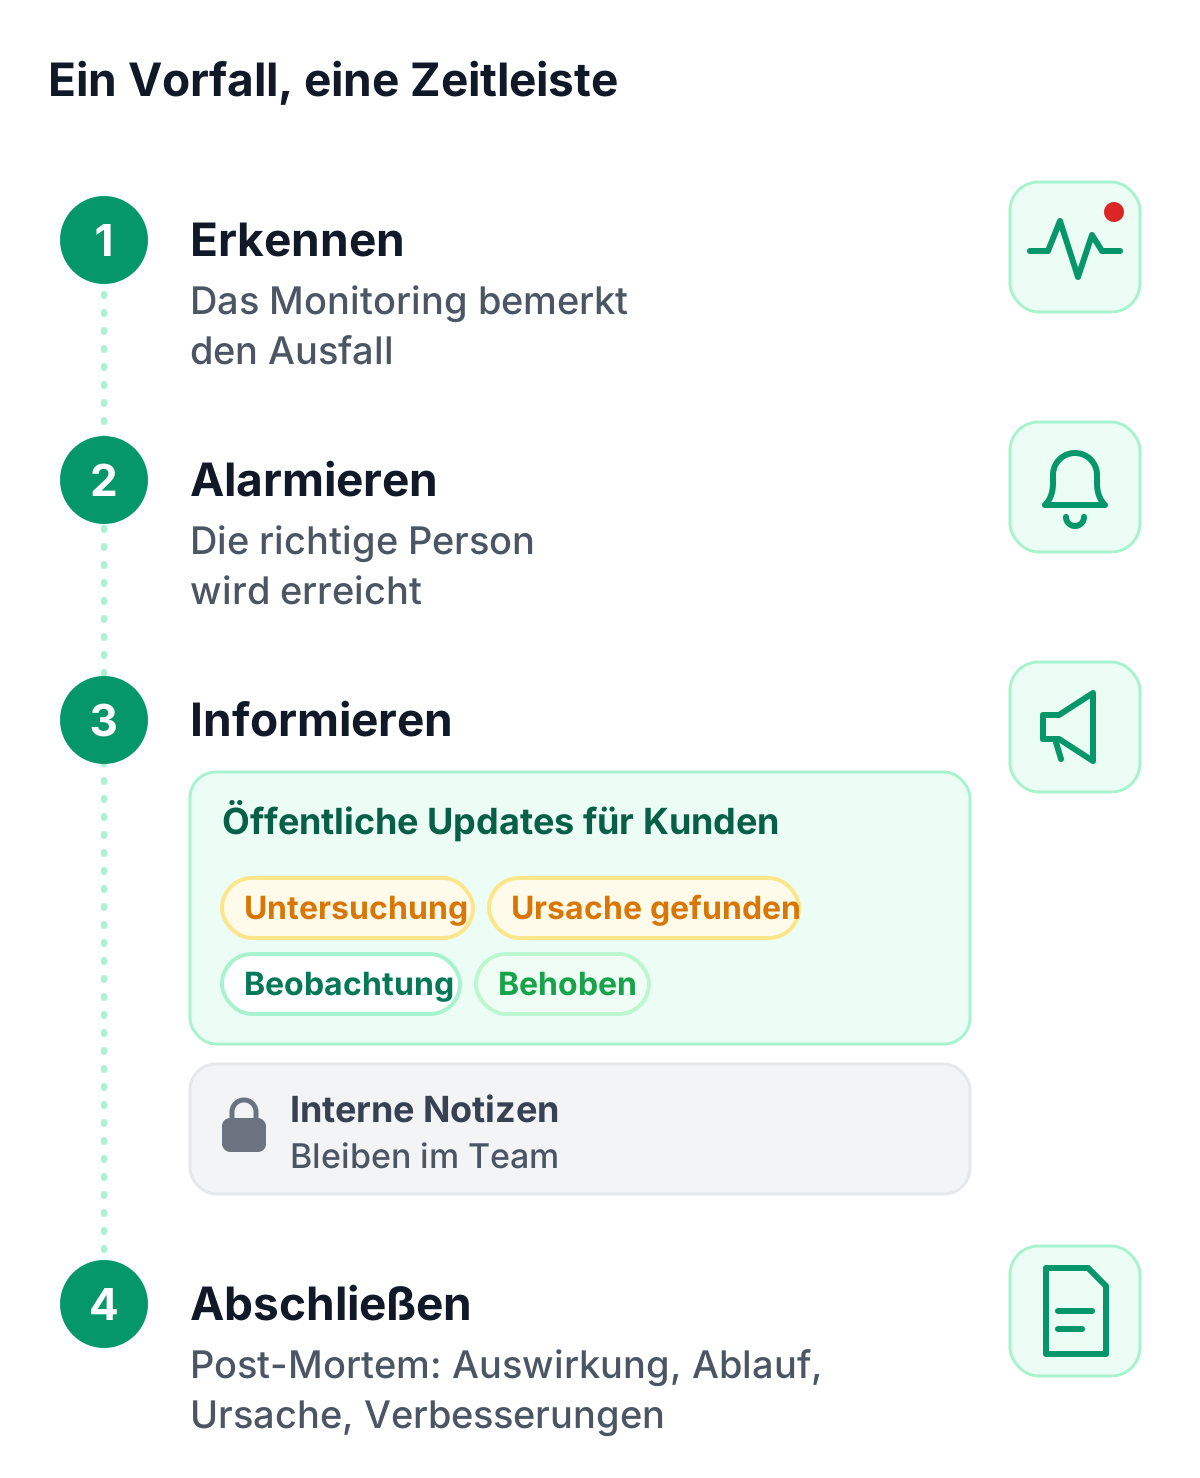
Tools für die Kommunikation im Incident Management funktionieren am besten, wenn sie miteinander verbunden sind: Monitoring, das das Problem erkennt, Alarmierung, die die richtige Person erreicht, und eine Statusseite, die Kunden informiert. Dahinter steht eine gemeinsame Zeitleiste. So muss niemand Informationen zwischen Tools hin- und herkopieren, während der Vorfall noch läuft.
Wie TrustComponent Monitoring deinen Plan unterstützt
TrustComponent Monitoring bringt diese Teile auf einer europäischen Plattform zusammen:
- Erkennung und Alarmierung: Prüfungen bis zu alle 30 Sekunden, Alarme in 16 Kanälen, Eskalationsketten mit bis zu 20 Stufen und Bestätigung per Klick
- Vorfall-Entwürfe: Fällt ein überwachter Service aus, liegt ein vorausgefüllter Vorfall-Entwurf bereit. Ohne deine Entscheidung wird nichts veröffentlicht
- Eine Zeitleiste, zwei Zielgruppen: öffentliche Updates für Kunden und interne Notizen für dein Team, mit Anhängen
- Vier Kategorien: Vorfälle, geplante Wartungen, informative Hinweise und Sicherheitsereignisse
- Post-Mortems und Export: Schließe Vorfälle mit einem strukturierten Post-Mortem ab und exportiere den vollständigen Datensatz als PDF/ZIP
- Abonnenten: Updates erreichen Abonnenten automatisch, in deinem Branding und in der Sprache deiner Statusseite
Entdecke alle Funktionen für das Vorfall-Management.
Fazit
Vorfälle passieren; ein Plan sorgt dafür, dass die Kommunikation drumherum ruhig und einheitlich bleibt. Lege Rollen und Schweregrade fest, bereite deine Vorlagen vor und schließe jeden schweren Vorfall mit einem Post-Mortem ab. Deine Kunden werden sich an ein Team erinnern, das sie auf dem Laufenden gehalten hat.
Jetzt starten
👉 Teste TrustComponent Monitoring kostenlos und verbinde Monitoring, Vorfälle und Statusseite an einem Ort.