Les CAPTCHAs visuels reposaient sur une hypothèse : les bots ne savent pas lire les images comme les humains. Pendant un temps, c’était à peu près vrai. Ce n’est plus le cas. Contourner un CAPTCHA visuel est aujourd’hui un service bien documenté et bon marché, vendu quelques dollars le millier de requêtes. Pour qui protège un site, les questions utiles sont donc de savoir comment fonctionnent ces attaques et quelle protection tient encore.
Pourquoi les CAPTCHAs visuels sont des cibles faciles
Les CAPTCHAs traditionnels posent un défi visuel : lire un texte déformé, repérer tous les feux de circulation, faire glisser une pièce de puzzle à sa place. L’idée était que les ordinateurs ne savaient pas interpréter de façon fiable des images ambiguës, contrairement aux humains. Comprendre comment fonctionnent les CAPTCHAs au niveau du mécanisme montre où cette hypothèse ne tient plus.
Les modèles de vision par ordinateur battent désormais les humains sur de nombreuses tâches de classification d’images, y compris les types de défis utilisés par les systèmes CAPTCHA. La note du W3C sur l’inaccessibilité des CAPTCHAs signale depuis 2005 des problèmes de fiabilité et d’accessibilité des défis visuels, et l’écart entre humains et machines sur les tâches de reconnaissance n’a fait que se réduire depuis.
Un CAPTCHA qui repose uniquement sur la reconnaissance peut être battu de deux façons : automatiser la reconnaissance ou payer un humain pour la faire. Les deux sont bien établies.
Comment les bots contournent les CAPTCHAs
Frameworks d’automatisation : Selenium, Playwright et navigateurs headless
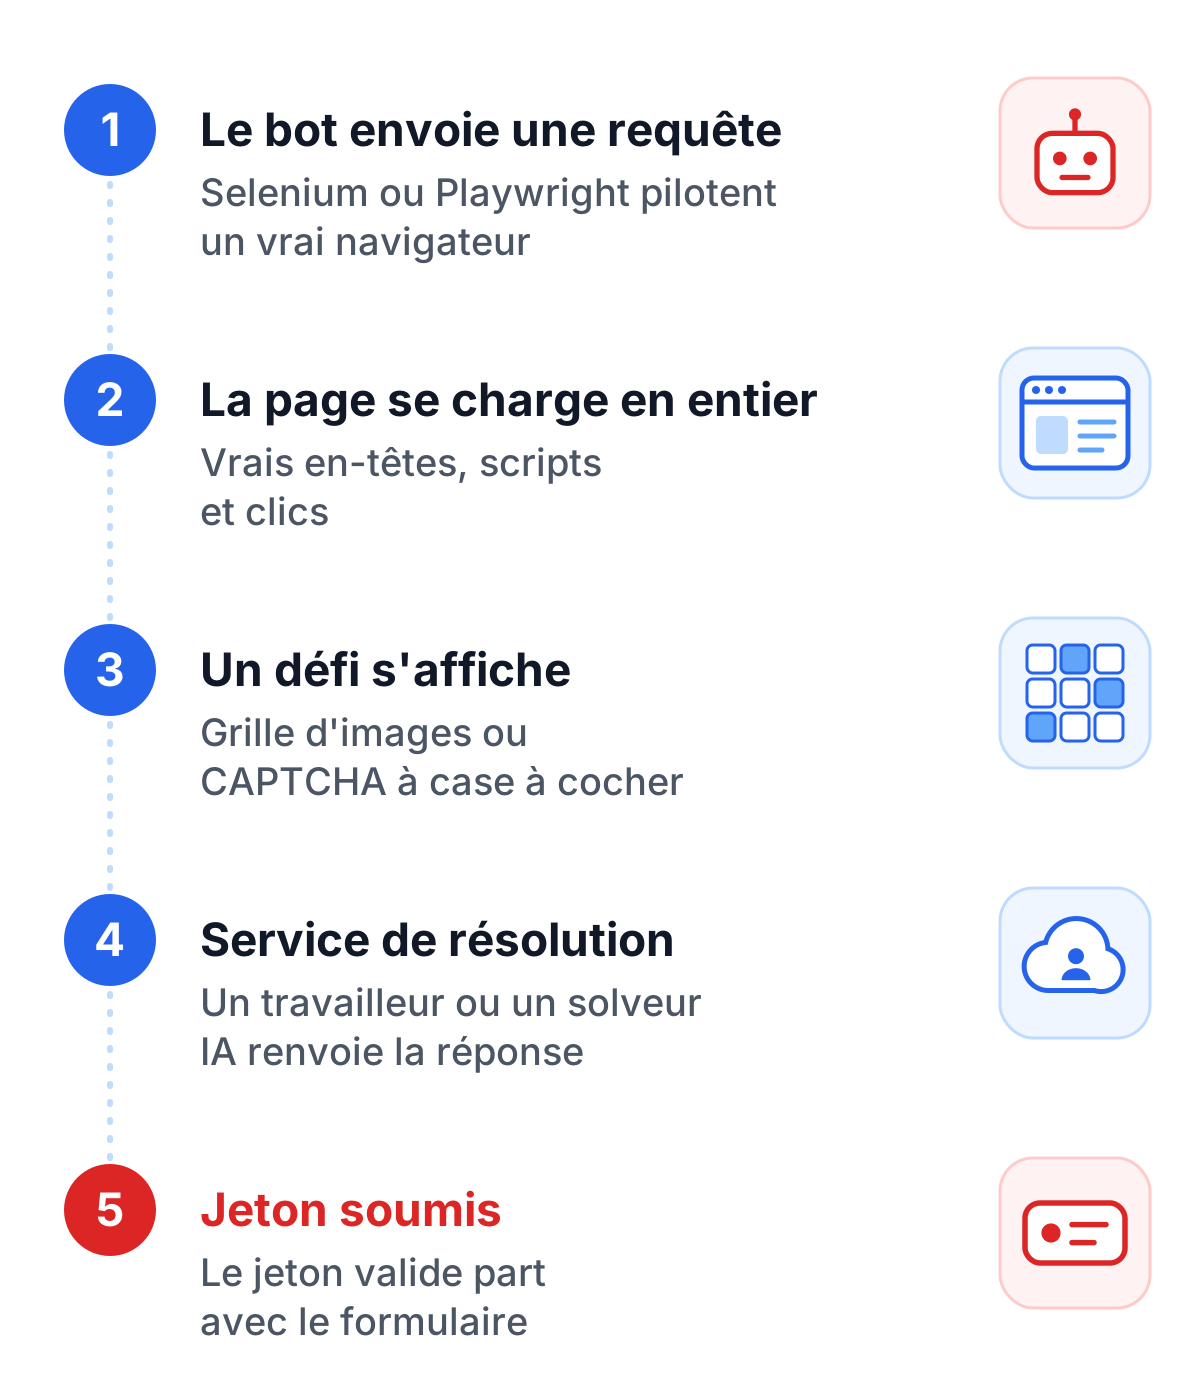
Selenium et Playwright sont des outils d’automatisation de navigateur conçus pour tester des applications web. Ils pilotent de vrais navigateurs (Chrome, Firefox, Edge), exécutent JavaScript, gèrent les cookies et manipulent les éléments de la page comme le ferait une personne. Un bot qui passe par Playwright envoie de vrais en-têtes de navigateur, charge la page entière et déclenche des clics là où un utilisateur cliquerait.
Un CAPTCHA qui vérifie seulement si quelqu’un a coché une case ne distingue pas un clic humain d’un clic automatisé. Le navigateur est réel, l’interaction aussi.
Les navigateurs headless vont encore plus loin. Chrome Headless fonctionne sans fenêtre visible, ce qui le rend plus rapide et moins cher à faire tourner à grande échelle : les attaquants peuvent lancer des milliers de sessions automatisées en parallèle avec très peu d’infrastructure.
Services de résolution de CAPTCHA
Lorsque l’automatisation seule ne parvient pas à interpréter un défi visuel, les bots le confient à un service de résolution. Il existe deux grands modèles.
Les fermes à base humaine paient des travailleurs pour résoudre des CAPTCHAs ; le bot leur transmet les défis automatiquement et reçoit les réponses en quelques secondes. Les prix tournent autour de 1 à 3 dollars le millier de solutions. Pour des cibles rentables, comme les inscriptions de comptes, les achats de billets ou le credential stuffing, ce coût ne pèse presque rien pour l’attaquant.
Les solveurs fondés sur l’IA sont des réseaux de neurones entraînés sur de grands volumes de défis CAPTCHA. Ils tournent en local, ne coûtent presque rien par requête et résolvent la plupart des défis textuels avec une précision quasi parfaite. Sur les défis visuels, les résultats varient selon le type, mais l’écart avec les humains se réduit pour tous.
La course aux armements de la reconnaissance
La difficulté des CAPTCHAs visuels suit un schéma clair : les défis se durcissent, les solveurs progressent, et les utilisateurs légitimes supportent l’essentiel de la friction. Les CAPTCHAs mathématiques l’illustrent bien. À leur apparition, ils semblaient une alternative simple et raisonnable aux défis visuels. Aujourd’hui, n’importe quel script d’automatisation basique les résout. Les défis visuels plus complexes tiennent plus longtemps, mais chaque version finit par tomber à mesure que les modèles accumulent des données de défis.
Pourquoi les défis de reconnaissance ne tiennent pas
Le problème n’est pas un manque d’imagination des concepteurs de CAPTCHA. La reconnaissance est tout simplement le mauvais test. Toute tâche décrite assez précisément pour entraîner une machine finira par être automatisée, et cela vaut pour tous les défis visuels jamais utilisés dans un CAPTCHA.
Durcir les défis ne règle pas le problème, cela ne fait que gagner du temps. Et cela pèse lourdement sur les personnes ayant un handicap visuel ou cognitif, pendant que les opérateurs de bots attendent le prochain modèle.
La limitation de débit et le blocage d’IP aident à la marge. Les bots qui passent par Playwright à un rythme humain restent sous les seuils de débit simples, et les opérations plus importantes font tourner leurs adresses IP via des réseaux de proxies résidentiels. Ces mesures réduisent le volume d’une attaque, mais ne disent rien de l’intention derrière une requête.
Ce qui fonctionne vraiment : une défense en couches
Une protection qui résiste au contournement moderne ne remplace pas un test de reconnaissance par un autre plus difficile. Elle ajoute une couche qui ne dépend pas du tout de la reconnaissance.
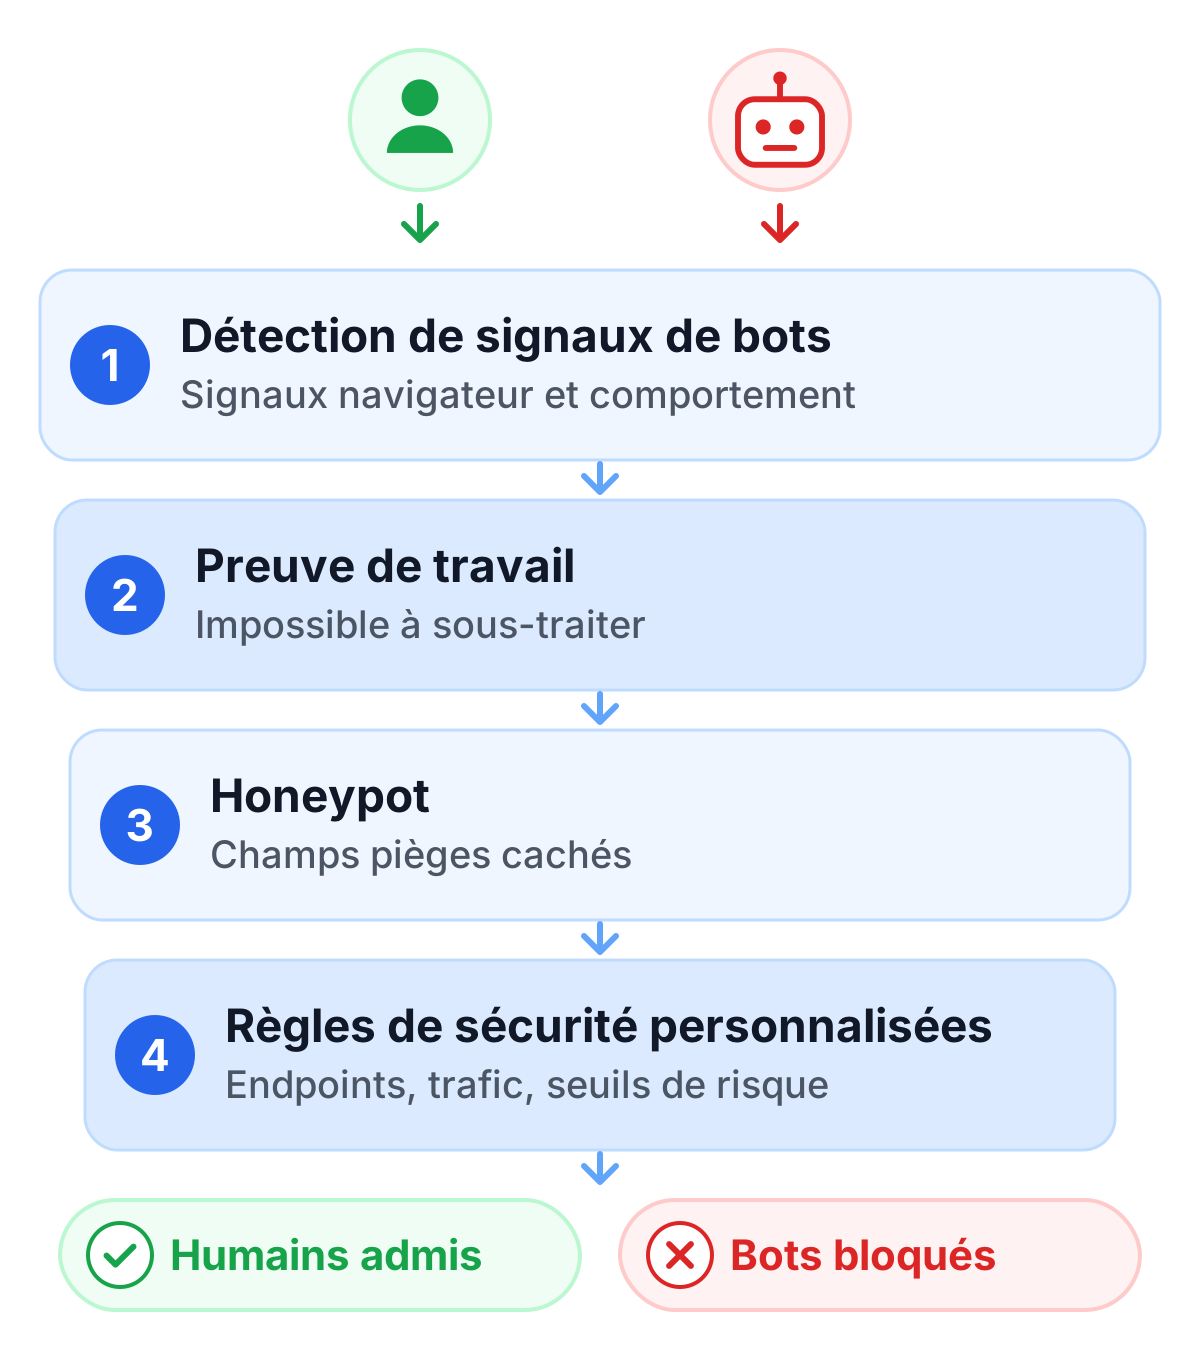
Détection de signaux de bots
La détection de bots fondée sur les signaux du navigateur et du comportement repère le trafic automatisé dans de nombreux cas. Les systèmes qui en tirent un score de bot peuvent signaler les requêtes suspectes avant même qu’un défi ne soit affiché.
Cette couche arrête déjà une grande part des bots et du spam. Les opérations plus sophistiquées sont toutefois conçues précisément pour passer sous la détection fondée sur les signaux, d’où la nécessité d’une seconde couche.
Preuve de travail : la couche qui ne se sous-traite pas
La preuve de travail demande au navigateur de calculer quelque chose plutôt que de reconnaître quelque chose. La tâche est cryptographique : un calcul de hachage qui demande un vrai temps de traitement. Le navigateur d’un utilisateur légitime l’effectue en arrière-plan pendant que l’utilisateur continue.
Pour une seule requête, le coût est négligeable. Pour une opération de bots qui exécute des milliers de sessions simultanées, le calcul s’additionne. Contrairement à la reconnaissance d’images, il ne peut pas être confié à une ferme de résolution humaine, car une personne ne calcule pas un hachage à la main ; seules les machines le peuvent. Et contrairement aux solveurs d’images par IA, aucun entraînement ne fournit de raccourci. Le travail doit être fait.
Quand les signaux de risque augmentent, la difficulté de la preuve de travail monte automatiquement. Le trafic à faible risque passe vite ; le trafic suspect reçoit une tâche plus difficile. Les vrais utilisateurs ne sont pas interrompus, car le calcul s’exécute pendant qu’ils remplissent le formulaire.
C’est ce qui distingue la preuve de travail des approches fondées sur la reconnaissance : le coût pour l’attaquant augmente avec la taille de l’attaque. Les CAPTCHAs visuels deviennent moins chers à contourner à mesure que les modèles progressent. La preuve de travail, non.
TrustCaptcha : des couches qui travaillent ensemble
TrustCaptcha exécute les deux mécanismes l’un après l’autre. Chaque requête est évaluée à partir des signaux du navigateur et du comportement. Pour les vrais utilisateurs, la tâche de preuve de travail s’exécute en arrière-plan. Pour les requêtes présentant des signaux de risque plus élevés, la difficulté augmente automatiquement.
Il n’y a ni image à transmettre à une ferme de résolution, ni case qu’un script Playwright pourrait cocher. Les fonctionnalités de détection de bots assurent le premier filtre ; la preuve de travail fait le reste. Un bot qui échappe à une couche se heurte quand même à l’autre.
En plus, TrustCaptcha ajoute un contrôle honeypot et prend en charge des règles de sécurité personnalisées. Les exploitants de site y définissent des conditions précises qui déclenchent des actions supplémentaires. Les règles peuvent porter sur des conditions comme l’adresse IP, le pays, la langue, le fuseau horaire, le navigateur, le système d’exploitation ou l’appareil, si bien que les équipes contrôlent le comportement de la protection dans leur propre contexte au lieu de dépendre uniquement du scoring automatique.
Pour les sites qui cherchent des alternatives au CAPTCHA sans dépendance à Google ni exposition au RGPD, TrustCaptcha fonctionne dans des centres de données européens et ne dépose aucun cookie. Un accord de traitement des données est inclus dans chaque abonnement, sans négociation juridique séparée.
Points clés à retenir
- Les CAPTCHAs visuels peuvent être contournés de façon fiable avec des frameworks d’automatisation de navigateur comme Selenium ou Playwright, ou via des services de résolution de CAPTCHA à moins de 3 dollars le millier de défis.
- Durcir les défis visuels pénalise surtout les utilisateurs légitimes. Cela ne règle pas le problème de fond : les tâches de reconnaissance sont automatisables.
- La détection de signaux de bots arrête déjà une grande part des bots et du spam. Les opérations plus sophistiquées sont conçues pour y échapper, d’où la nécessité d’une seconde couche.
- La preuve de travail est la couche qui tient quand la détection échoue. Elle exige un vrai calcul, qui ne peut être ni confié à des humains ni accéléré par l’IA.
- Un CAPTCHA comme TrustCaptcha, qui combine détection de signaux de bots, preuve de travail et règles de sécurité personnalisées, rend les tentatives de contournement coûteuses et plus faciles à repérer. Que l’attaque repose sur l’automatisation, les services de résolution ou une évasion avancée, au moins une couche s’applique.
Essayez TrustCaptcha gratuitement
Vos utilisateurs ne devraient pas avoir à résoudre des puzzles pour prouver qu’ils sont humains, et vous ne devriez pas avoir à choisir entre une expérience fluide et une protection fiable. Essayez TrustCaptcha gratuitement pendant 14 jours : une vérification sans puzzle qui s’exécute pendant que vos utilisateurs remplissent le formulaire, et une protection contre les bots qui résiste aux tentatives de contournement modernes.