Qu’est-ce que la détection de bots ?
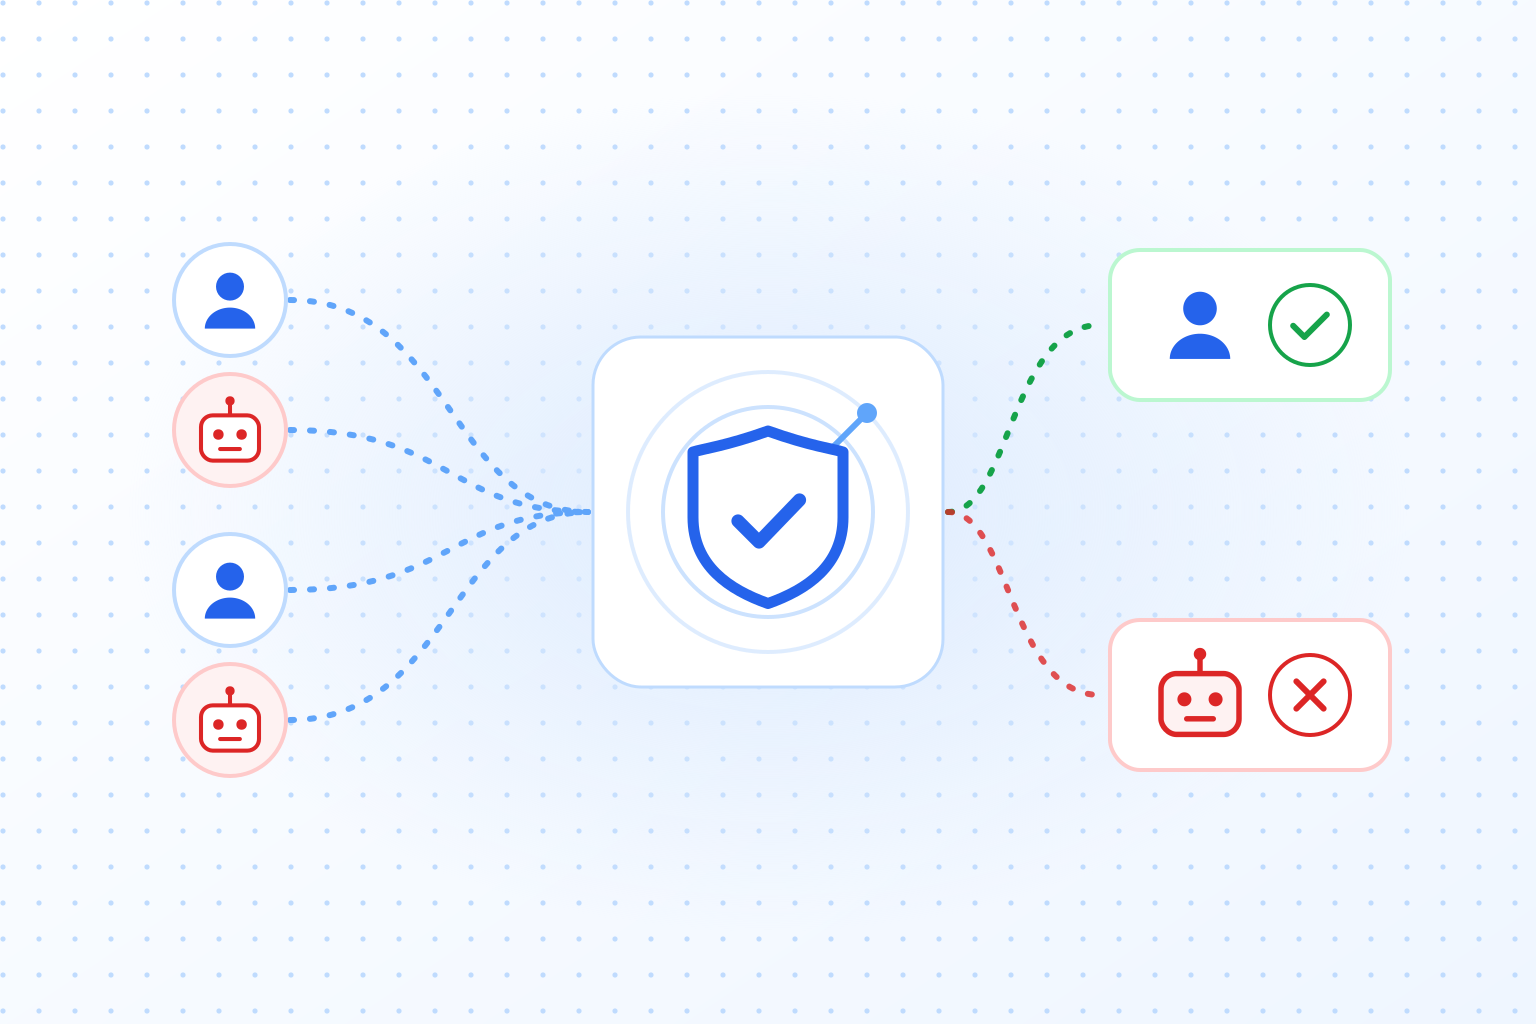
La détection de bots consiste à déterminer si une requête vient d’une personne ou d’un programme. Elle examine la façon dont la requête est construite, le comportement de la session et l’environnement dans lequel elle s’exécute, puis transforme ces signaux en décision : autoriser, vérifier à nouveau ou bloquer.
Le trafic bot atteint presque toutes les parties d’un produit moderne : création de compte, connexion, paiement, recherche, pages de tarifs, contenus et API. Une partie de ce trafic est utile et attendue. Les ennuis commencent quand des bots ignorent vos règles pour chercher des failles, copier du contenu, simuler de l’engagement ou consommer vos ressources. Mieux vaut donc traiter le trafic bot comme un risque d’exploitation permanent plutôt que comme un nettoyage ponctuel.
Une bonne détection de bots identifie ce trafic avec certitude et l’arrête sans dégrader l’expérience utilisateur. TrustCaptcha, un CAPTCHA invisible qui ne demande rien aux visiteurs, est conçu pour les équipes qui veulent cette protection sans puzzles, sans interruptions et sans perte de conversions.
Qu’est-ce que le trafic bot ?
Le trafic bot désigne tout trafic non humain vers un site, une application ou une API. On emploie souvent le terme pour dire « activité malveillante », mais la réalité est plus nuancée. Des programmes automatisés servent votre activité lorsqu’ils s’identifient, se comportent de façon prévisible et restent dans des limites raisonnables. La même automatisation devient nuisible quand elle se cache, tourne à haut volume ou cherche à manipuler des résultats.
Le trafic bot devient un problème de sécurité et de fiabilité lorsqu’il vise des actions qui ont de la valeur : authentification, transactions, réservations de stock, accès au contenu, ou traitements qui vous coûtent de l’argent à chaque exécution (e-mails, SMS, calcul, API tierces payantes). Les attaquants visent ce qui se démultiplie à bas coût et rapporte de façon mesurable. Le gain peut être un vol, des données extraites ou une simple perturbation.
Bons bots, bots « gris » et bots malveillants
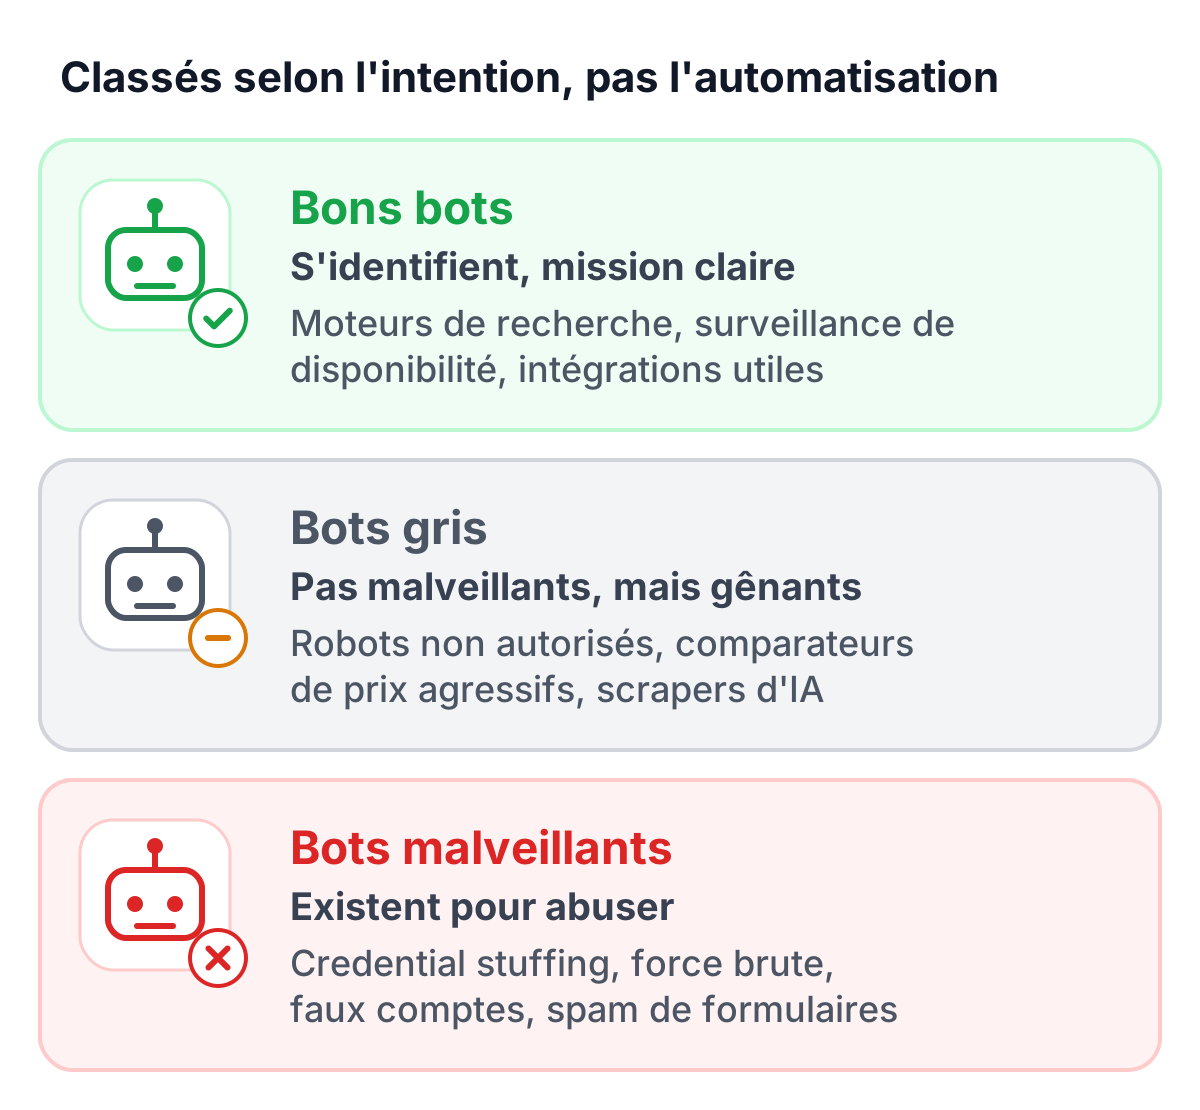
Tous les bots ne doivent pas être bloqués. Mieux vaut les classer selon leur intention et selon qu’ils respectent vos règles, plutôt que selon le seul fait qu’ils soient automatisés.
Les bons bots s’identifient généralement et remplissent une mission claire. Les robots d’indexation des moteurs de recherche, la surveillance de disponibilité et les intégrations dont vos utilisateurs dépendent en font partie. Ils sont les bienvenus tant que vous pouvez vérifier qui ils sont et ce qu’ils font.
Les bots gris ne sont pas forcément malveillants, mais ils posent quand même problème. Pensez aux robots d’exploration non autorisés, aux comparateurs de prix agressifs ou aux scrapers d’IA qui ignorent les règles d’exploration et font grimper vos coûts. Ils faussent vos statistiques et vos mesures de performance. Ils peuvent aussi charger vos serveurs au point de déclencher des limitations de débit qui pénalisent ensuite les vrais utilisateurs.
Les bots malveillants existent pour abuser. Les schémas typiques sont le credential stuffing (tester des identifiants volés), les tentatives de connexion par force brute, la création de faux comptes, le spam de formulaires, la fraude aux clics publicitaires, le scraping massif de contenu, l’accaparement de paniers et de stock, et le trafic de déni de service. Les attaquants s’en servent aussi pour sonder vos faiblesses et cartographier vos défenses.
L’objectif n’est donc pas d’arrêter toute automatisation. Il s’agit de laisser la confiance décider de l’accès aux parcours sensibles : qui interagit, comment, et peut-on raisonnablement le traiter comme un utilisateur légitime ?
Pourquoi le trafic bot est un risque pour l’entreprise
On réduit souvent le trafic bot à une nuisance technique. Son impact sur l’entreprise est pourtant concret, et il s’accumule. Dès que des bots atteignent votre produit, ils causent des dégâts dans au moins quatre domaines.
Premièrement, les bots faussent les décisions. Avec un trafic gonflé, vos statistiques ne reflètent plus ce que veulent les utilisateurs. Des changements produit semblent réussir ou échouer pour de mauvaises raisons, les tests A/B perdent leur valeur statistique et l’analyse des entonnoirs de conversion n’est plus fiable. Les équipes finissent par livrer des « optimisations » qui répondent à du bruit.
Deuxièmement, les bots coûtent directement de l’argent. Les requêtes automatisées consomment de la bande passante, de la capacité serveur et base de données, et des quotas de services tiers. Même un scraping inoffensif peut déclencher des rendus coûteux et des échecs de cache. Pour une start-up, ce coût peut faire très mal ; pour une grande plateforme, il modifie quand même le coût par utilisateur et la planification des capacités.
Troisièmement, les bots sapent la confiance. Les comptes de spam dégradent la qualité d’une communauté, les fausses inscriptions polluent les données du CRM et les tentatives de fraude automatisées alourdissent le support. Quand de vrais utilisateurs se heurtent à des blocages, des alertes de sécurité ou des pages lentes, ils perdent confiance dans le produit.
Quatrièmement, les bots rendent la fraude possible. Le credential stuffing transforme la réutilisation des mots de passe en prises de contrôle de comptes. L’accaparement de stock laisse les vrais clients devant des produits épuisés. Les tentatives de paiement automatisées et les tests de cartes bancaires font de votre plateforme un outil pour les attaquants et vous entraînent dans des litiges, des rétrofacturations et des atteintes à votre réputation.
La défense contre les bots n’est donc pas une simple fonctionnalité. Elle fait partie de l’exploitation d’un service digne de confiance, quelle que soit sa taille.
Comment identifier le trafic bot
La détection de bots détermine si une interaction est plus probablement humaine ou automatisée. Les bons dispositifs combinent plusieurs niveaux : observation en bordure du réseau, analyse du comportement dans le navigateur ou l’application, et application de règles sur les points d’accès sensibles. Aucun signal ne suffit à lui seul, car les attaquants s’adaptent. Il vous faut un classement qui tient encore quand quelqu’un cherche activement à le tromper.
Les ingénieurs repèrent souvent l’automatisation simple directement dans les logs : requêtes qui répètent un schéma rigide, rythme qu’aucun humain ne peut tenir, user agents suspects ou rafales venant d’un petit nombre d’adresses IP. Mais l’automatisation moderne change d’adresse IP, falsifie les en-têtes et utilise des navigateurs headless pour paraître légitime. Détecter les bots exige donc aussi des signaux de plus haut niveau, difficiles à falsifier de façon constante.
Les outils d’analyse d’audience vous alertent tôt, mais ce ne sont pas des outils de sécurité. Ils révèlent des anomalies qui doivent déclencher une enquête et des ajustements de vos défenses.
Anomalies d’audience souvent liées aux bots
Un pic soudain de pages vues qui ne correspond à aucune campagne, aucun lancement ni aucune mention dans la presse est un signal d’alerte courant. Il en va de même pour des taux de rebond étranges, soit extrêmement élevés (une page, puis départ), soit étonnamment bas (des parcours parfaits sur plusieurs pages), qui peuvent trahir une navigation scriptée.
La durée des sessions peut trahir les bots dans les deux sens. Certains vont trop vite et cliquent à une vitesse qu’aucune personne n’atteint. D’autres ralentissent volontairement pour passer inaperçus, ce qui produit des sessions longues et étrangement uniformes. Regardez la distribution, pas seulement la moyenne : le comportement humain est désordonné, le comportement scripté se regroupe.
Les conversions indésirables sont un autre indice. Des formulaires avec des noms inventés, des adresses e-mail suspectes, des numéros de téléphone impossibles ou le même texte type encore et encore viennent généralement de l’automatisation. Lors de la création de comptes, un grand nombre d’inscriptions depuis une même région, un même réseau (ASN) ou un même profil d’appareil est un signal fort, surtout si vous ne servez pas cette région.
Aucun de ces signaux ne prouve à lui seul une activité de bots. Ils vous indiquent où ajouter de la journalisation, où intervenir et où des contrôles plus stricts valent l’effort.
Pourquoi filtrer les statistiques ne revient pas à arrêter les bots
Beaucoup d’équipes commencent par filtrer les bots connus dans leur outil d’analyse d’audience, et c’est une bonne hygiène. Cela retire de vos rapports le bruit des robots reconnus. Mais cela ne protège pas vos systèmes. Le trafic atteint toujours vos serveurs, déclenche toujours vos traitements et provoque toujours des abus. Si vous voulez arrêter la fraude, garder des performances stables et protéger vos utilisateurs, il vous faut des mécanismes d’application, pas seulement des rapports plus propres.
En bref, filtrer améliore la mesure, et la lutte contre les bots améliore la sécurité et la fiabilité. Vous avez besoin des deux, mais ils ne résolvent pas le même problème.
Les techniques clés de la détection de bots moderne
Les techniques de détection de bots se répartissent en quelques catégories. Les bonnes mises en œuvre n’en choisissent pas une seule : elles les combinent en une décision unique.
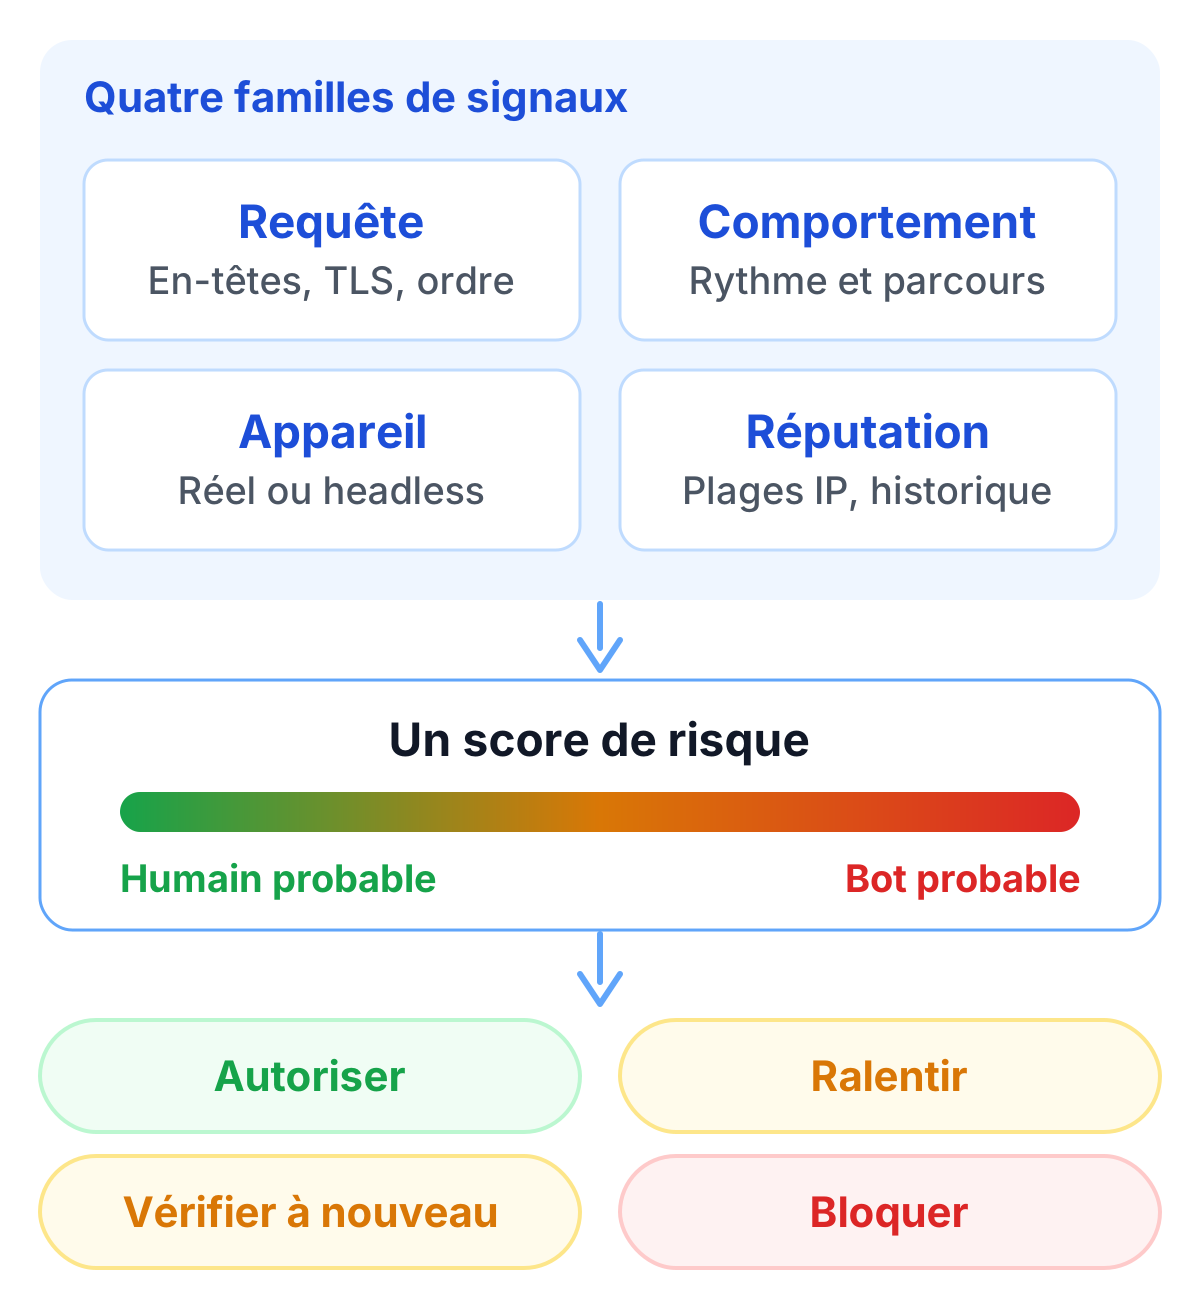
L’analyse des requêtes et des protocoles examine la façon dont les requêtes sont construites. Les bots commettent souvent de petites erreurs dans la composition des en-têtes, les empreintes TLS, l’ordre des champs ou la cohérence d’une requête à l’autre. Même des outils sophistiqués laissent des traces visibles à grande échelle.
L’analyse comportementale observe le déroulement d’une interaction. Les gens font défiler la page de façon irrégulière, hésitent, corrigent leurs fautes de frappe et se promènent. Les bots vont droit au but : ils envoient des formulaires avec un timing exact, suivent des séquences parfaites et répètent le même schéma d’une session à l’autre. Les bonnes analyses comportementales s’appuient sur de nombreux petits signaux plutôt que sur un seul geste, car un ensemble de signaux est difficile à imiter de façon convaincante.
Les signaux liés à l’appareil et à l’environnement vérifient si l’environnement du navigateur semble réel. Les attaquants font souvent tourner leur automatisation dans des navigateurs headless, des émulateurs ou des outils conçus pour échapper à la détection. Un défenseur peut repérer les écarts entre ce que le navigateur prétend être et la façon dont il se comporte réellement.
La réputation et le renseignement sur les menaces s’appuient sur l’historique : plages d’IP connues pour des abus, réseaux de centres de données, groupes d’anomalies et schémas observés sur de nombreux déploiements. C’est utile, mais à manier avec prudence, sous peine de bloquer des utilisateurs légitimes qui partagent une infrastructure avec des attaquants.
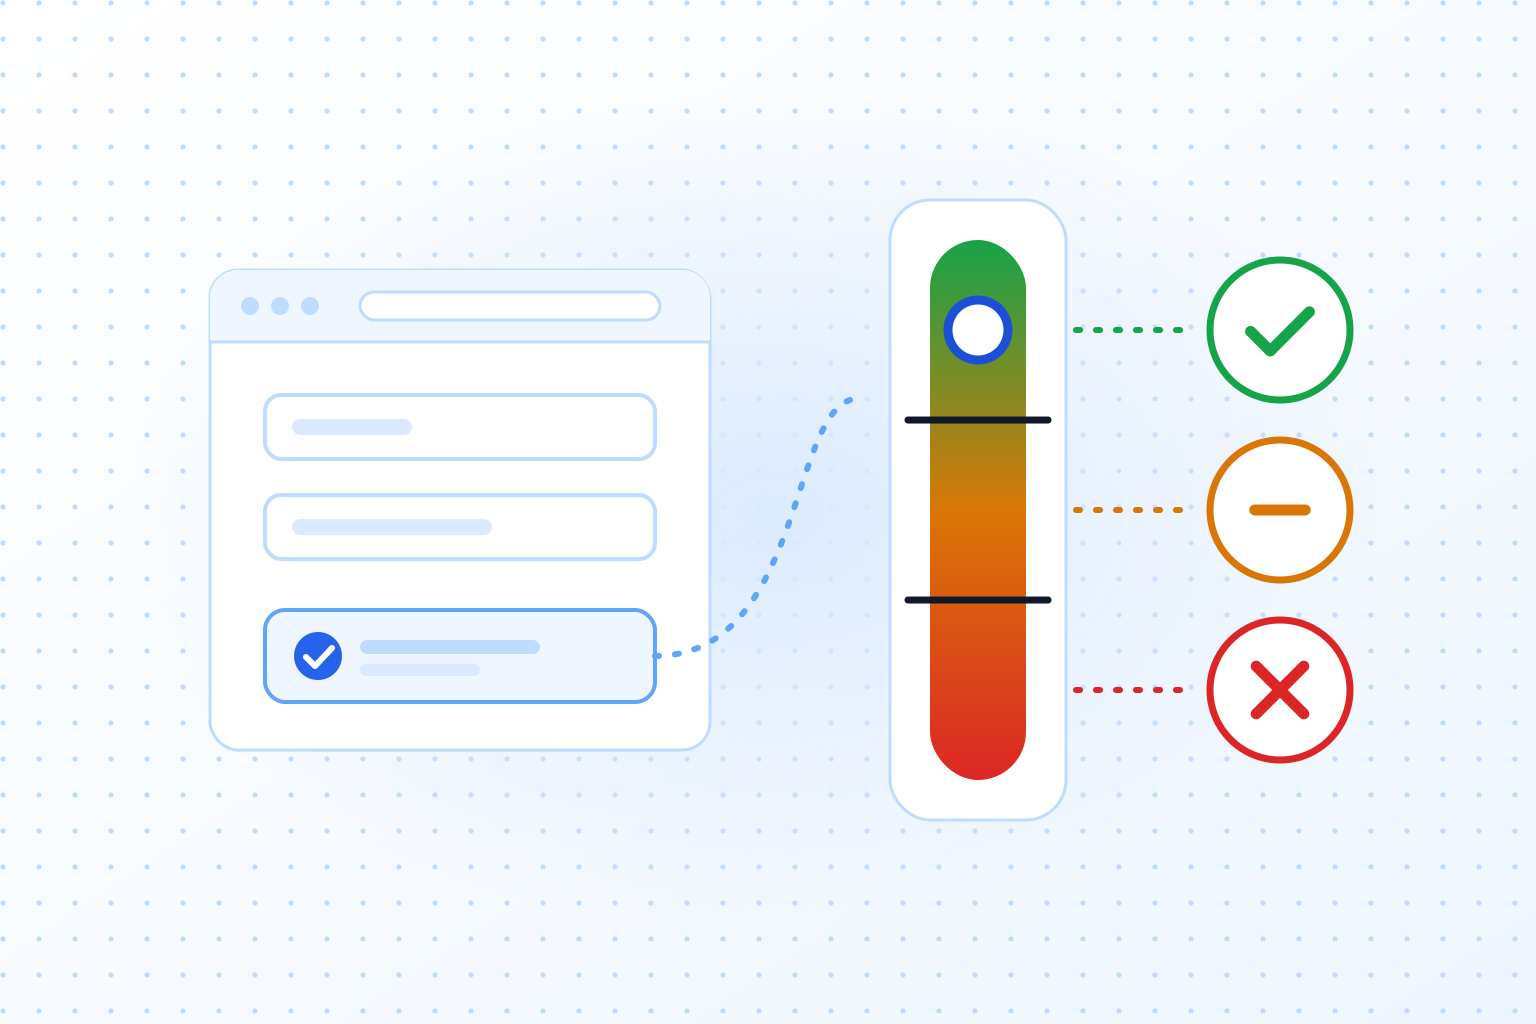
Le scoring de risque et l’application adaptative transforment les signaux en décisions. Au lieu d’un « bloquer ou autoriser » binaire partout, les systèmes matures attribuent un score de risque, souvent appelé score de bot, et réagissent différemment selon la valeur du point d’accès, l’état de l’utilisateur et l’intensité de l’attaque à ce moment-là.
C’est la direction que prend le domaine : moins de défis visibles, davantage d’évaluation discrète et continue.
Pourquoi les CAPTCHA traditionnels ne sont plus le bon choix par défaut
Les CAPTCHA traditionnels ont été conçus pour des bots plus simples et des attaques plus modestes. Aujourd’hui, leurs puzzles posent trois problèmes récurrents.
Ils freinent les vrais utilisateurs. Chaque étape qui interrompt une inscription ou un paiement augmente le taux d’abandon. Quand vous faites résoudre des puzzles, vous payez la sécurité avec votre chiffre d’affaires.
Ils nuisent à l’accessibilité et à la confiance. Les personnes en situation de handicap, celles qui ont une connexion mobile faible ou un appareil limité trouvent souvent les puzzles difficiles ou peu fiables. Cela devient un problème de conformité autant qu’un problème d’image.
Ils sont de plus en plus faciles à résoudre. Les attaquants envoient les puzzles à des fermes à clics, utilisent des solveurs fondés sur l’apprentissage automatique ou les confient à des humains rémunérés au sein de chaînes automatisées. Les CAPTCHA à puzzle finissent alors par taxer vos vrais utilisateurs pendant que les attaquants déterminés passent quand même.
Une approche moderne conserve la sécurité et rend leur temps aux utilisateurs.
Comment stopper le trafic bot : une stratégie en couches
On arrête le mieux le trafic bot avec plusieurs couches. Chaque couche augmente le coût pour l’attaquant, réduit le taux de réussite de l’automatisation et vous donne plus de maîtrise sur l’expérience utilisateur.
La première couche est la réduction de la surface d’attaque. Protégez uniquement ce qui doit l’être, mais protégez-le vraiment. Placez vos défenses sur les points d’accès qui ont de la valeur : authentification, inscription, réinitialisation du mot de passe, paiement, et tout formulaire coûteux ou exposé aux abus.
La deuxième couche regroupe les contrôles de débit et d’abus. Limitation de débit, quotas de requêtes et seuils d’anomalie réduisent les attaques à haut volume. Ils fonctionnent bien contre les bots simples, mais suffisent rarement seuls, car les attaquants expérimentés répartissent leur trafic.
La troisième couche est la vérification. C’est là qu’un contrôle sans puzzle montre sa valeur : il doit distinguer les humains de l’automatisation avec peu de friction et être difficile à contourner.
La quatrième couche est la réponse et le retour d’information. Quand vous bloquez ou vérifiez à nouveau du trafic, cette décision doit alimenter votre détection, pour que chaque attaque vous apprenne quelque chose.
Bien mise en œuvre, la défense en couches réduit à la fois les faux positifs et la charge de travail quotidienne.
La place de TrustCaptcha dans la détection de bots
TrustCaptcha est conçu pour les équipes qui ont besoin d’une solide protection anti-bot sans puzzles, sans interruptions et sans moments « prouvez que vous êtes humain ». Il fonctionne en arrière-plan et calcule une évaluation du risque à partir de signaux techniques et comportementaux, au lieu de demander quoi que ce soit à l’utilisateur.
Les utilisateurs ne remarquent pas la vérification, et c’est tout l’intérêt. Les utilisateurs légitimes terminent leur parcours sans distraction, tandis que l’abus automatisé se heurte à une barrière bien plus haute. L’effort passe de l’utilisateur à l’attaquant.
La différence se voit surtout là où la conversion compte. Connexion, inscription, réinitialisation du mot de passe et paiement tolèrent très peu de friction. Un contrôle qui préserve la conversion tout en arrêtant l’automatisation reste activé. Un contrôle qui coûte des inscriptions est remis en question en interne chaque trimestre.
La preuve de travail comme couche de sécurité supplémentaire
Sous forte attaque, la classification seule ne suffit pas toujours. Quand des attaquants peuvent envoyer de grands volumes de requêtes automatisées à bas coût, la lutte contre les bots doit aussi rendre l’abus économiquement absurde. Une méthode éprouvée consiste à ajouter une couche de preuve de travail (proof-of-work, PoW) : avant qu’une action sensible soit acceptée, le client doit effectuer un petit calcul limité. Pour un utilisateur légitime, ce calcul reste invisible et se termine vite. Pour des bots à grande échelle, il devient coûteux, car l’attaquant paie le coût de calcul pour chaque tentative.
La PoW est surtout utile contre l’automatisation à haute fréquence, comme le credential stuffing, les soumissions de formulaires scriptées et les rafales de trafic destinées à épuiser vos ressources. Les attaquants savent contourner les listes de blocage et les empreintes fragiles ; la PoW modifie plutôt leur courbe de coûts. Chaque requête supplémentaire a un coût que ni la rotation des adresses IP ni la falsification des en-têtes ne peuvent supprimer. La PoW complète donc bien l’analyse comportementale et le scoring de risque, surtout quand les bots sont distribués et difficiles à rattacher à une seule source.
En pratique, la PoW apporte de la stabilité. Moins de requêtes abusives atteignent les traitements coûteux, les performances risquent moins de chuter lors des vagues de bots, et maintenir une attaque demande plus d’efforts. Utilisée là où elle compte, plutôt que comme barrière sur chaque page, elle renforce votre défense contre les bots sans placer d’obstacles devant les utilisateurs.
Concevoir la décision : autoriser, ralentir, vérifier à nouveau ou bloquer
Une bonne défense contre les bots repose rarement sur une seule réponse. La réponse doit correspondre au risque et à la valeur du point d’accès.
Les interactions à faible risque peuvent passer sous surveillance. Les sessions à risque moyen peuvent être ralenties ou invitées à réessayer. Les actions à haut risque, comme des tentatives de connexion répétées ou des soumissions de formulaires en masse, doivent être bloquées sans hésiter. L’avantage d’une vérification fondée sur le risque est de pouvoir être strict là où cela compte et souple là où l’expérience utilisateur passe en premier.
TrustCaptcha soutient ce modèle en donnant à vos règles une base de décision : votre serveur reçoit le résultat avec le score de bot, ce qui vous permet de verrouiller les actions critiques tout en gardant une navigation ordinaire fluide.
Les signaux que les attaquants peinent à falsifier durablement
Un attaquant falsifie un user agent en quelques secondes. Il peut changer d’adresse IP. Il peut imiter un comportement de navigateur basique. Ce qui est bien plus difficile, c’est de rester cohérent sur toute l’interaction : rythme, variété de la navigation, ordre des événements et environnement qui tient debout.
La détection de bots devient fiable quand vous regardez la session dans son ensemble plutôt qu’une suite de requêtes isolées. Les humains laissent des imperfections naturelles : pauses, corrections, chemins irréguliers et changements de contexte. L’automatisation produit de l’uniformité. Même quand les attaquants rendent leur comportement aléatoire, ce hasard paraît artificiel à grande échelle.
Une approche moderne et invisible s’appuie sur ces différences durables. Vous n’attraperez pas tous les bots avec une seule astuce. Vous pouvez en revanche rendre l’automatisation soutenue coûteuse, peu fiable et visible.
Une mise en œuvre méthodique
La protection contre les bots fonctionne le mieux quand vous la mesurez et l’ajustez. Commencez par les points d’accès les plus visés et suivez les résultats : taux de réussite des soumissions, répartition des échecs de connexion, groupes de sessions suspectes et ce que les abus vous coûtent en tickets de support, pics de charge et données de mauvaise qualité.
Déployez TrustCaptcha là où vous pouvez mesurer l’effet rapidement. Dans beaucoup de produits, protéger l’inscription et la réinitialisation du mot de passe rapporte tout de suite : moins de faux comptes, moins de spam, un CRM plus propre, des coûts d’e-mail en baisse et moins d’abus en aval.
Étendez ensuite la couverture au fil de ce que vous apprenez. Le but n’est pas de bloquer le plus possible. Le but est que les vrais utilisateurs passent et que l’abus automatisé échoue, de façon fiable et prévisible.
Gestion d’incident : que faire pendant une attaque
Quand une attaque de bots s’intensifie, votre équipe a besoin d’un plan clair. Chacun doit savoir quels indicateurs signalent une escalade et quelles actions peuvent être prises sans risque.
Renforcez d’abord les contrôles sur les points d’accès les plus précieux. Abaissez les limites de débit pour les schémas clairement abusifs, mais évitez les blocages larges qui touchent des utilisateurs légitimes sur des réseaux partagés. Servez-vous des résultats de vérification pour séparer le trafic : laissez passer les sessions de confiance et contenez fermement les sessions suspectes.
Après l’incident, organisez un court bilan centré sur ce que vous avez appris : quels points d’accès étaient visés, quelles règles ont fonctionné, où se sont produits les faux positifs et quels traitements ont coûté plus que prévu. Les équipes qui gèrent bien les bots utilisent chaque attaque pour affiner leur prochain réglage.
Mesurer le succès
Un programme anti-bot réussit quand les résultats de l’entreprise s’améliorent, pas quand il affiche un nombre impressionnant de blocages. Les bons indicateurs sont une baisse durable des conversions indésirables, moins de comptes de spam, moins d’abus à la connexion, une charge serveur plus stable et des statistiques plus propres. Dans beaucoup d’organisations, le signe le plus net est que les équipes font de nouveau confiance à leurs chiffres et peuvent mener des expériences sans se demander si l’automatisation a dicté le résultat.
TrustCaptcha y contribue en arrêtant l’abus automatisé tout en protégeant l’expérience utilisateur que ces chiffres décrivent.
Essayer TrustCaptcha
Si vous voulez réduire l’abus automatisé sans ajouter d’étapes pour vos utilisateurs, placez TrustCaptcha là où cela compte le plus : vos formulaires, inscriptions, connexions et parcours de paiement. Vous obtenez une détection de bots avec laquelle vos visiteurs n’ont jamais à interagir. La preuve de travail dynamique fait partie de chaque offre payante, et la détection de bots avec le score de bot commence avec l’offre Solo.
Chaque offre commence par un essai gratuit de 14 jours, et les sites non commerciaux peuvent utiliser TrustCaptcha gratuitement. Commencez votre essai gratuit sur vos points d’accès les plus exposés et laissez les utilisateurs légitimes avancer sans interruption.