

Qu’est-ce que la souveraineté des données ?
La souveraineté des données est le principe selon lequel les données sont régies par les lois et l’autorité réglementaire d’une juridiction donnée. En termes pratiques, cela signifie que les données personnelles, les dossiers financiers, la propriété intellectuelle et les journaux opérationnels peuvent être soumis à des obligations légales, à des règles de divulgation et à des mesures d’exécution liées au pays ou à la région associés aux données et à leur traitement.
La difficulté tient au fait que les services numériques restent rarement à un seul endroit. Les données sont collectées à la périphérie, traitées dans les couches applicatives, analysées par des outils de sécurité et stockées dans des systèmes distribués. Chaque étape peut ajouter une nouvelle juridiction. La souveraineté des données concerne donc non seulement l’endroit où les données « vivent », mais aussi l’endroit où elles sont traitées, les régimes juridiques applicables et les entités, publiques ou privées, susceptibles d’exiger l’accès.
Dans de nombreuses organisations, la souveraineté des données est traitée comme une simple case de conformité à cocher. Cela ne tient pas longtemps. La souveraineté doit pouvoir être appliquée, ce qui suppose une vision claire des flux de données, des choix de traitement délibérés et des contrôles qui restent efficaces sous pression : changement de fournisseur, croissance internationale, réponse à un incident et demandes juridiques.
Concepts fondamentaux : souveraineté, résidence, localisation et contrôle
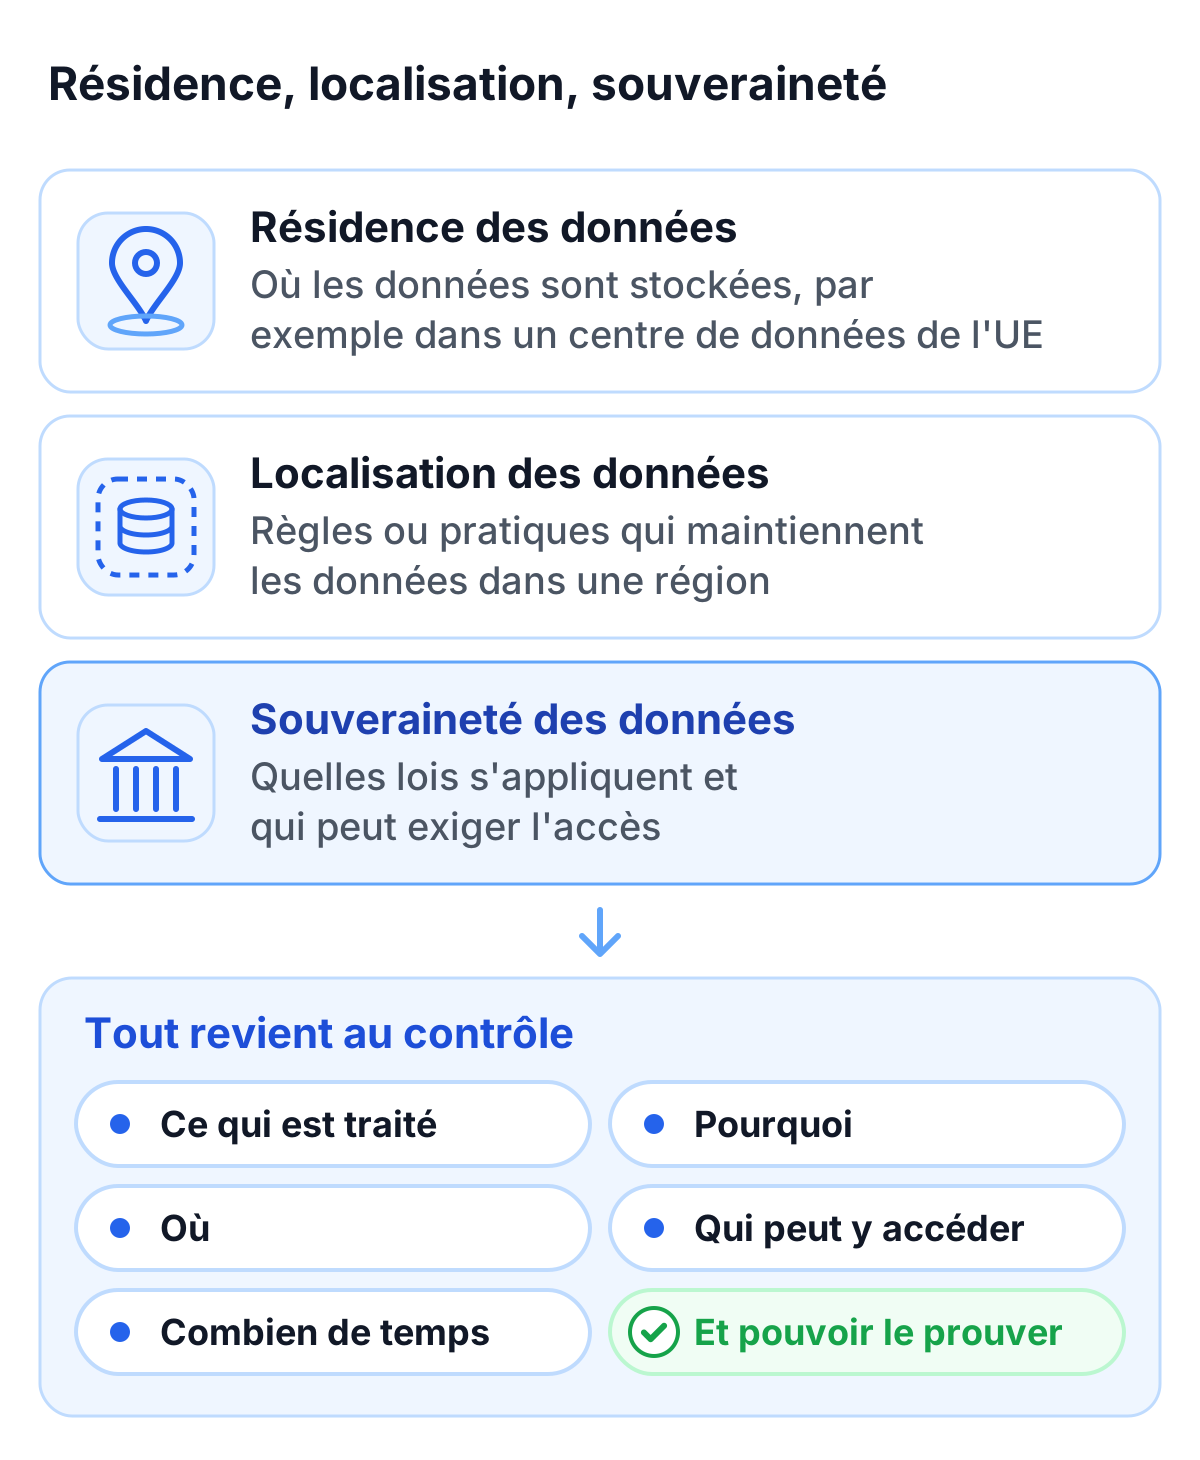
La souveraineté des données est souvent discutée aux côtés de deux termes connexes : la résidence des données et la localisation des données. Bien qu’ils soient liés, ils décrivent des contraintes différentes et nécessitent donc des contrôles différents.
La résidence des données renvoie à l’endroit où les données sont stockées, par exemple dans un centre de données de l’UE, un environnement sur site ou un pays spécifique. La localisation des données est la pratique ou l’exigence consistant à conserver certaines catégories de données dans les limites physiques ou opérationnelles d’une juridiction. La souveraineté se concentre sur l’autorité juridique et les obligations, y compris les attentes réglementaires, les règles d’accès licite et la capacité à démontrer la conformité et la gouvernance.
La souveraineté repose donc sur une idée centrale : le contrôle. Le contrôle, c’est la capacité à décider ce qui est traité, pourquoi, où, qui peut y accéder et combien de temps cela persiste, et à pouvoir le prouver. Sans contrôle, « hébergement dans l’UE » reste une formule marketing plutôt qu’une véritable position de conformité et de sécurité.
Pourquoi la souveraineté des données compte dans les systèmes réels
La souveraineté des données pèse de plus en plus parce que les services numériques sont à la fois plus distribués et plus réglementés. Les organisations opèrent au-delà des frontières, s’appuient sur des infrastructures cloud, intègrent de multiples prestataires et déploient des outils de sécurité à des points critiques de l’interaction utilisateur. Chaque dépendance peut étendre la surface juridique et technique des données.
La souveraineté compte pour la vie privée parce que les utilisateurs et les régulateurs attendent des protections juridiques prévisibles. Elle compte pour la sécurité parce que les attaquants ne respectent pas les frontières, tandis que la réponse aux incidents et la criminalistique doivent les respecter. Elle compte pour les opérations parce que la disponibilité et la résilience dépendent de choix d’architecture qui peuvent être contraints par des exigences régionales. Elle compte également pour la confiance, car les utilisateurs finaux jugent de plus en plus un service à la façon dont il traite les données, et pas seulement à ses fonctionnalités.
La conséquence pratique : la souveraineté est une exigence de conception. Si elle n’est pas traitée comme telle, elle réapparaît plus tard sous la forme d’un projet de remédiation coûteux, souvent déclenché par une évaluation réglementaire, un audit fournisseur ou un incident de sécurité.
La souveraineté des données dans le contexte de la conformité à la vie privée
Les lois sur la vie privée et les réglementations sectorielles définissent des obligations autour de la limitation des finalités, de la minimisation, de la transparence, de la conservation et de la sécurité. La souveraineté des données recoupe ces obligations en déterminant quel cadre juridique s’applique et quels mécanismes d’exécution existent.
Prenons le cas d’un service qui collecte des identifiants utilisateur, des informations de facturation ou des données liées à la santé. Même lorsque le service a son siège en dehors de l’Europe, le traitement des données personnelles d’utilisateurs européens déclenche généralement des obligations juridiques européennes. Parallèlement, si un composant tiers traite des données en dehors de l’UE, des obligations liées aux transferts transfrontaliers et des étapes de gouvernance supplémentaires peuvent apparaître. La complexité augmente lorsque plusieurs juridictions se chevauchent, créant un besoin d’harmoniser la conformité plutôt que d’optimiser pour un seul ensemble de règles.
Une conformité centrée sur la souveraineté devient donc une question de maturité de la gouvernance : savoir cartographier les flux de données, limiter le traitement à ce qui est nécessaire et prouver que les contrôles fonctionnent comme décrit. Cette page explique les notions ; ceci n’est pas un conseil juridique, voyez leur application à votre cas avec votre délégué à la protection des données (DPO).
Comment appliquer la souveraineté des données : stratégies pratiques
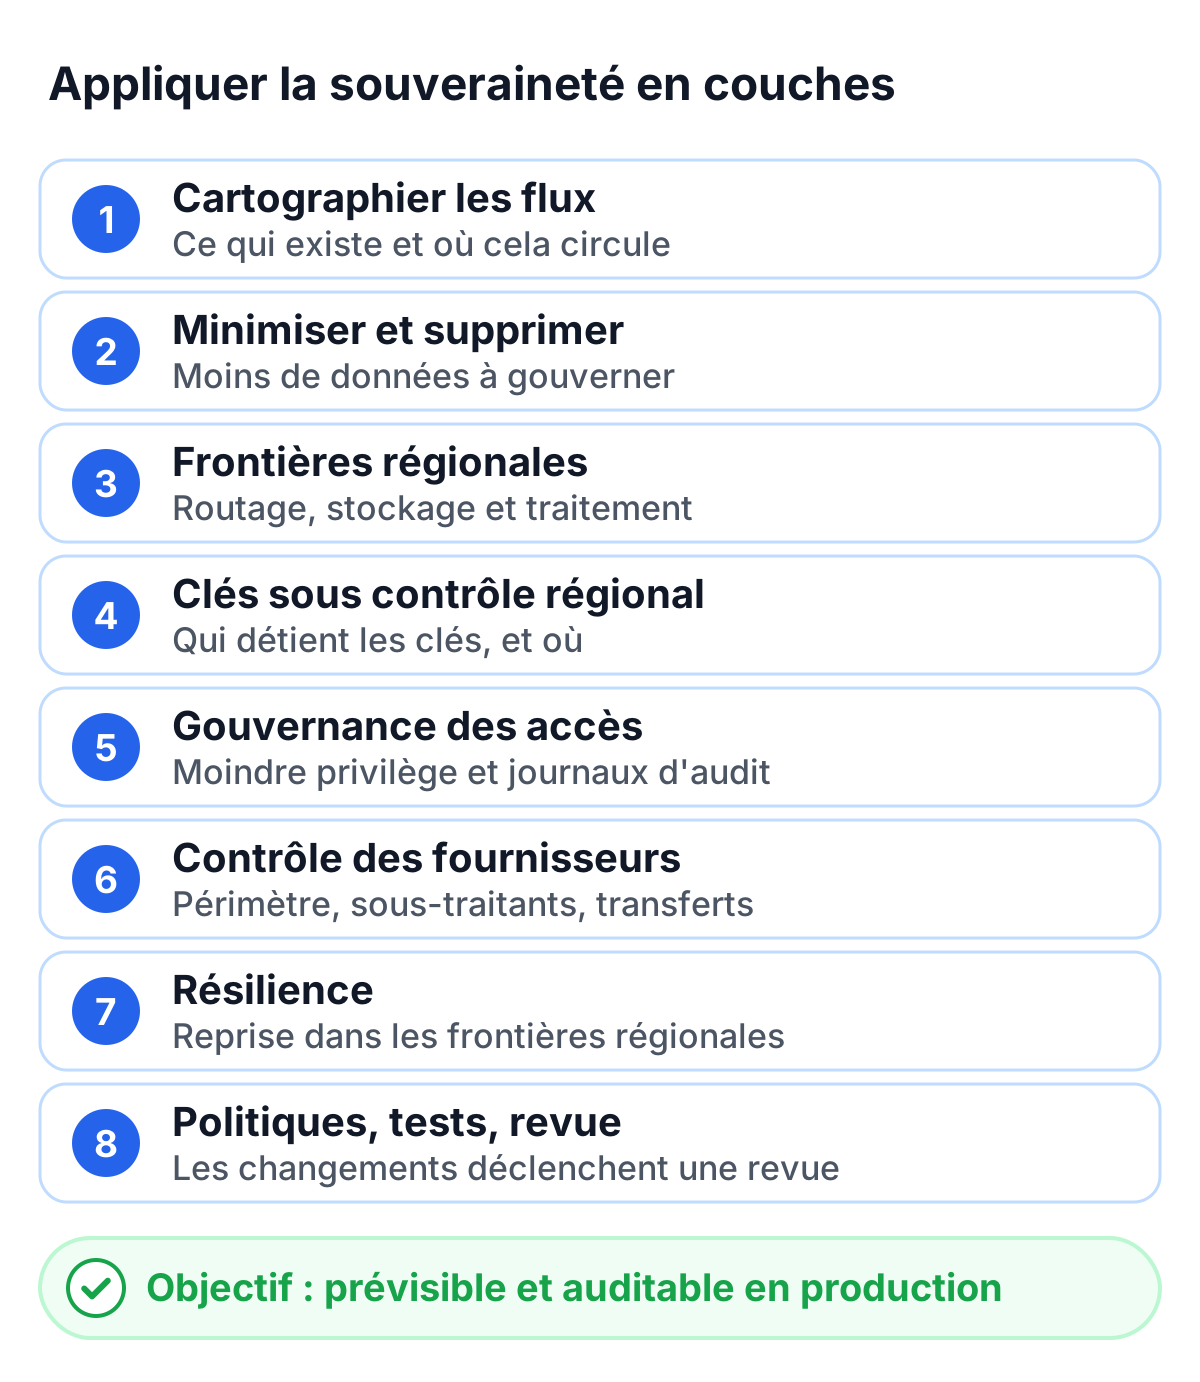
L’application de la souveraineté des données fonctionne le mieux comme un système de contrôle en couches. Les engagements juridiques, les mesures techniques et les procédures opérationnelles doivent se renforcer mutuellement. L’objectif n’est pas seulement d’être conforme sur le papier, mais d’être prévisible et auditable en production.
1) Cartographier les flux de données et attribuer une signification juridique aux données
L’application commence par la visibilité. Les organisations ont besoin d’un inventaire des données qui identifie quelles données existent, d’où elles proviennent, ce qu’elles contiennent et quels processus les utilisent. Un simple tableur ne suffit pas : il faut une représentation tenue à jour de la manière dont les données circulent à travers les systèmes et les fournisseurs. Lorsque cette cartographie fait défaut, la souveraineté est supposée au lieu d’être appliquée.
Une approche utile consiste à relier les catégories de données aux obligations légales et aux niveaux de risque. Les données personnelles, les signaux d’authentification, les métadonnées de paiement et la télémétrie de sécurité n’ont pas le même impact en matière de conformité ou de violation. Les traiter comme équivalents conduit à la fois à une surcollecte et à un sous-contrôle.
2) Minimiser la collecte et réduire la persistance par conception
La souveraineté est plus facile à appliquer lorsqu’il y a moins de données à gouverner. La minimisation réduit les besoins de transferts transfrontaliers, diminue l’impact d’une violation et améliore la défendabilité des décisions de traitement. La discipline de conservation est tout aussi importante : des données qui ne sont pas conservées ne peuvent pas être consultées plus tard à la suite d’un compromis, d’une mauvaise configuration ou d’une divulgation contrainte.
La minimisation ne signifie pas une télémétrie de sécurité au rabais. Elle signifie collecter les bons signaux pour une finalité définie et les supprimer dès qu’ils ne sont plus nécessaires.
3) Concevoir des frontières de traitement régionales
De nombreux échecs de souveraineté se produisent involontairement à cause de l’architecture. Un système peut stocker des données dans une région tout en les traitant dans une autre via des outils d’analyse centralisés, des pipelines de logs ou des API de fournisseurs. L’application exige des frontières explicites : routage régional, stockage régional et traitement régional. Cela inclut de s’assurer que les données « en arrière-plan » (comme les logs, la télémétrie de limitation de débit et les signaux antifraude) suivent la même politique régionale que les données utilisateur principales.
Un modèle pratique consiste à segmenter par juridiction : déployer des points d’accès propres à chaque région, des bases de données délimitées par région et des outils d’observabilité adaptés à chaque région. Lorsqu’une analyse globale est nécessaire, privilégiez des signaux agrégés ou anonymisés qui ne réintroduisent pas de données personnelles dans les flux transfrontaliers.
4) Conserver le contrôle cryptographique dans la juridiction visée
Le chiffrement est souvent présenté comme un contrôle de sécurité ; dans le cadre de la souveraineté, il devient un contrôle d’accès. Un chiffrement fort garantit que des données répliquées ou interceptées restent inutilisables sans clés autorisées. La question devient alors : qui contrôle les clés, où sont-elles stockées et dans quelles conditions peuvent-elles être consultées ?
Les conceptions alignées sur la souveraineté visent généralement à maintenir la gestion des clés sous contrôle régional et à restreindre l’accès administratif via des processus renforcés. Cela est particulièrement pertinent lors de l’utilisation de services managés, où la frontière entre « contrôles du fournisseur » et « contrôles du client » peut devenir floue sans dispositions contractuelles et techniques explicites.
5) Appliquer une gouvernance stricte des accès et de l’auditabilité
Si la souveraineté concerne l’autorité, c’est dans l’accès que cette autorité se manifeste concrètement. Les organisations doivent mettre en œuvre des contrôles d’accès fondés sur les rôles, le moindre privilège et une authentification forte pour les actions administratives. Elles doivent aussi tenir des journaux d’audit infalsifiables pour les événements sensibles d’accès et de traitement, alignés sur les politiques de conservation et les besoins de réponse aux incidents.
L’auditabilité fait la différence entre « nous pensons être conformes » et « nous pouvons prouver que nous sommes conformes ».
6) Contrôler les voies de transfert transfrontalier et les dépendances fournisseurs
Les fournisseurs tiers peuvent devenir des sous-traitants silencieux de données. L’application exige une évaluation des fournisseurs spécifique aux flux de données, et non générique. Un fournisseur peut être « conforme » de manière générale tout en introduisant malgré tout des problèmes de transferts transfrontaliers pour un déploiement particulier.
Une application concrète inclut la limitation du périmètre fournisseur, l’exigence d’une gouvernance transparente des sous-traitants ultérieurs, la restriction des catégories de données que les fournisseurs peuvent traiter et la documentation des mécanismes de transfert lorsque cela est requis. Lorsque c’est possible, privilégiez pour les services destinés à l’UE des fournisseurs qui traitent les données dans l’UE, afin de réduire la complexité des transferts et de garder une gouvernance cohérente.
7) Considérer la résilience opérationnelle comme faisant partie de la souveraineté
La souveraineté ne concerne pas seulement la conformité juridique ; elle vise aussi à garantir que les services critiques restent disponibles et contrôlables dans le respect des contraintes régionales. Les plans de reprise après sinistre et de continuité d’activité doivent respecter les frontières régionales des données. Les stratégies de réplication doivent être conçues de manière à ce que la résilience ne devienne pas un mécanisme de transfert déguisé.
8) Institutionnaliser la souveraineté par les politiques, les tests et la revue
La gouvernance échoue lorsqu’elle est rédigée une fois puis jamais revue. L’application exige une gestion du changement : nouvelles fonctionnalités, nouveaux outils d’analyse, nouveaux fournisseurs de sécurité et nouvelles régions doivent déclencher une revue. Les tests de sécurité et les analyses d’impact relatives à la protection des données doivent inclure des vérifications de souveraineté : quelles données sont créées, où elles vont, qui peut y accéder et combien de temps elles persistent.
Le risque de souveraineté caché : les couches de sécurité tierces sur les parcours utilisateurs critiques
Un angle mort récurrent dans les programmes de souveraineté est la couche de sécurité la plus proche des utilisateurs finaux. La protection de l’authentification, la détection de fraude et l’atténuation des bots s’exécutent souvent sur les parcours de connexion, d’inscription, de réinitialisation de mot de passe, de paiement et de formulaires à forte valeur. Ces parcours correspondent à certains des moments utilisateurs les plus sensibles, et ils génèrent des signaux qui peuvent être personnellement identifiables selon le contexte.
Cela crée un vrai conflit : les organisations doivent défendre ces parcours contre les abus automatisés, mais les outils défensifs eux-mêmes peuvent élargir le périmètre de traitement des données. Si un service CAPTCHA ou de protection contre les bots s’appuie fortement sur le suivi, sur une prise d’empreinte large des appareils à des fins sans rapport ou sur un traitement transfrontalier, il crée des problèmes de souveraineté précisément là où l’organisation a le plus besoin de prévisibilité. Les analyses reCAPTCHA RGPD et hCaptcha RGPD montrent ce que cela donne pour deux services très répandus.
Une approche alignée sur la souveraineté garde la protection contre les bots et la rend cohérente avec les principes de souveraineté : limitation des finalités, minimisation, traitement régional et gouvernance solide.
Pourquoi un CAPTCHA souverain sur le plan des données compte pour la cybersécurité
Le credential stuffing, la création automatisée de comptes, le scraping et les campagnes de spam ciblent les mêmes points d’accès que ceux qui préoccupent le plus votre programme de conformité. Lorsque le trafic bot réussit, il provoque des incidents de sécurité, des atteintes à la vie privée et des perturbations opérationnelles. Le contrôle défensif (CAPTCHA ou équivalent) devient donc un composant de base de l’architecture de sécurité.
La question de la souveraineté est de savoir si ce contrôle peut être déployé sans introduire un risque disproportionné en matière de traitement des données. Un contrôle ne devrait pas résoudre un problème en en créant un autre. Avec un CAPTCHA souverain sur le plan des données, sécurité et conformité se renforcent : une protection efficace contre les bots réduit le risque de violation, et le traitement dans l’UE ainsi qu’une gestion soignée des données gardent la situation juridique simple.
TrustCaptcha : une protection anti-bots souveraine
TrustCaptcha est conçu comme une alternative CAPTCHA invisible et sans interaction. Il protège les formulaires, les connexions et les transactions contre les abus automatisés sans demander aux utilisateurs de résoudre des puzzles ni d’effectuer des défis contraignants ; le widget démarre tout seul. Cela aide la sécurité et l’expérience utilisateur, et aussi la souveraineté : plus le mécanisme est discret et peu persistant, plus il est facile de l’aligner avec les attentes de minimisation et de gouvernance.
Pour la souveraineté des données, les faits sont simples. TrustCaptcha ne dépose aucun cookie, traite les données dans des centres de données de l’UE et fournit un accord de traitement des données (DPA) à chaque client. L’entreprise, Trustcaptcha GmbH, est basée à Munich, en Allemagne. Pour une fonction de sécurité qui touche une grande partie de vos utilisateurs, les transferts hors UE disparaissent. Notre CAPTCHA conforme au RGPD met ces points en pratique, et le guide RGPD de TrustCaptcha donne le détail pour les délégués à la protection des données.
Pour comparer les fournisseurs européens, consultez notre aperçu du CAPTCHA européen.
TrustCaptcha a une finalité étroite : déterminer si une interaction est probablement humaine ou relève d’un abus automatisé, et réduire ces abus en limitant l’exposition des données.
Une comparaison pratique : que change l’objectif de souveraineté ?
| Critère | CAPTCHA traditionnel à défi | CAPTCHA « invisible » intensif en suivi | TrustCaptcha |
|---|---|---|---|
| Expérience utilisateur | Friction, puzzles, abandons | Souvent peu de friction | Sans interaction, sans puzzles |
| Traitement des données | Variable ; peut être large | Souvent large, persistant, proche de l’identité | Signaux de sécurité limités à la finalité et minimisés |
| Complexité des transferts | Dépend de la région du fournisseur | Inclut souvent un traitement transfrontalier | Traitement dans des centres de données de l’UE |
| Résultat sécurité | Peut être contourné, coûteux pour les utilisateurs | Utile mais pouvant soulever des préoccupations de vie privée | Forte atténuation des bots avec une conception compatible avec la gouvernance |
En pratique, lorsqu’un programme de souveraineté exige un contrôle régional et la minimisation, TrustCaptcha est une couche de sécurité qui travaille avec ces contraintes au lieu de s’y opposer.
Mettre en œuvre la souveraineté des données avec TrustCaptcha dans votre architecture
Dans les déploiements soucieux de la souveraineté, la protection contre les bots fonctionne le mieux comme un contrôle ciblé, et non comme une surveillance de tout le site. TrustCaptcha le permet en concentrant la protection là où elle compte : points d’accès d’authentification, récupération de compte, inscription, paiement et formulaires à haut risque. Cela réduit le volume de signaux traités tout en améliorant la valeur sécurité de ce qui est traité.
Du point de vue de la gouvernance, l’objectif est la cohérence : ce que votre documentation de protection des données dit de la protection contre les bots (son rôle, les grandes catégories de données, la finalité et la conservation) doit correspondre à ce qui tourne en production, et vos registres internes doivent dire la même chose. La formulation relève de votre délégué à la protection des données ; le guide RGPD de TrustCaptcha rassemble les faits pour TrustCaptcha.
Du point de vue de la cybersécurité, l’objectif est la résilience : la protection contre les bots doit s’intégrer à la supervision, à la limitation de débit, aux analyses d’abus et à la réponse aux incidents. Un contrôle aligné sur la souveraineté reste un contrôle de sécurité ; il doit produire des résultats exploitables sans laisser de traces de données inutiles.
Checklist d’application de la souveraineté des données (contrôles pratiques et auditables)
Un programme de souveraineté est plus solide lorsqu’il est mesurable. Les domaines de contrôle suivants sont couramment audités et opérationnellement pertinents :
- Veiller à ce que les lieux de traitement et la sous-traitance ultérieure soient documentés pour chaque dépendance externe utilisée dans les parcours utilisateurs critiques.
- Mettre en œuvre des fenêtres de conservation alignées sur les besoins opérationnels, avec suppression automatique.
- Garantir le chiffrement en transit et la gouvernance des clés cryptographiques pour les processus sensibles.
- Appliquer des contrôles d’accès administratifs stricts avec des journaux d’audit et des preuves vérifiables.
- Vérifier les frontières régionales dans les pipelines d’observabilité (logs, métriques, traces) afin d’éviter des transferts accidentels.
- Réévaluer périodiquement les configurations à mesure que les fonctionnalités, les régions et les lois évoluent.
Prochaines étapes
Si la souveraineté des données compte pour votre organisation, considérez la protection contre les bots comme faisant partie de votre frontière de souveraineté. TrustCaptcha protège les parcours critiques sans puzzle, ne dépose aucun cookie et traite les données dans des centres de données de l’UE : cette partie de votre système n’ajoute donc aucun transfert.
Chaque plan commence par un essai gratuit de 14 jours, et pour toute question sur votre configuration, vous pouvez nous contacter.