

Introduction : les incidents sont normaux, une communication claire est un choix
Toute équipe qui exploite des logiciels connaît des incidents. Ce dont les clients se souviennent ensuite, c’est rarement de l’incident lui-même, mais de la façon dont il a été communiqué : s’ils ont été informés rapidement, si les mises à jour étaient claires et si l’équipe a expliqué ce qu’elle en a retenu.
Un plan de communication d’incident rend cette partie prévisible. Ce guide explique ce que doit contenir le plan et vous fournit des modèles à copier et à adapter pour les mises à jour de page de statut, les avis de panne IT, les e-mails clients et le post-mortem.
Qu’est-ce qu’un plan de communication d’incident ?
Un plan de communication d’incident, parfois appelé plan de communication de réponse aux incidents, définit comment votre organisation communique pendant un incident :
- Qui communique, et qui valide les messages
- À qui : clients, équipes internes, direction, partenaires
- Par quels canaux : page de statut, e-mails aux abonnés, avis dans l’application, chat interne
- À quelle fréquence : le rythme des mises à jour pour chaque niveau de sévérité
- Ce qui se passe ensuite : le post-mortem et le suivi
C’est le volet communication de votre processus de gestion des incidents, et il fonctionne d’autant mieux qu’il est mis par écrit avant que vous en ayez besoin.
Les éléments du plan
Rôles
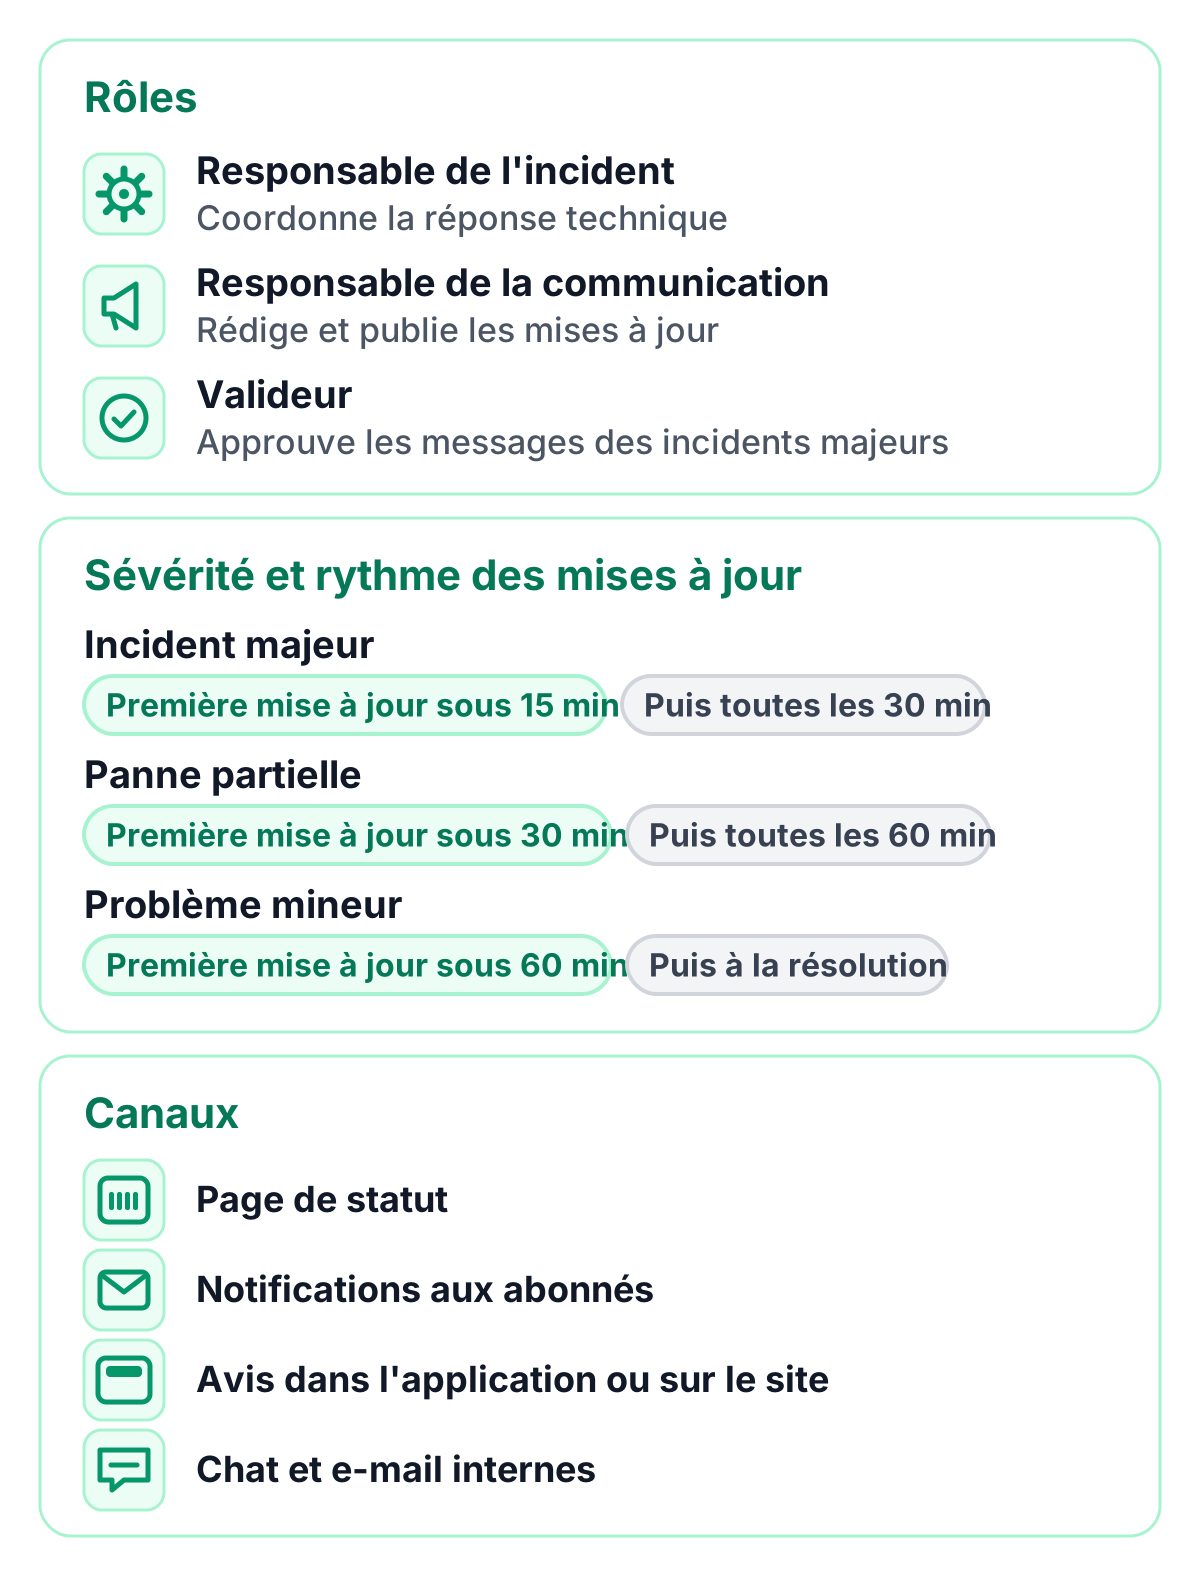
- Responsable de l’incident : coordonne la réponse technique.
- Responsable de la communication : rédige et publie les mises à jour, tient la chronologie à jour.
- Valideur : pour les incidents majeurs, une personne qui approuve les messages destinés aux clients.
Séparer le responsable de l’incident du responsable de la communication est la mesure la plus efficace : les mises à jour partent à temps pendant que les ingénieurs se concentrent sur le correctif.
Niveaux de sévérité et rythme des mises à jour
Définissez quelques niveaux de sévérité et décidez à l’avance comment vous communiquez pour chacun. Les valeurs ci-dessous sont un point de départ courant. Adaptez-les à votre SLA et à vos clients :
| Sévérité | Exemple | Première mise à jour | Mises à jour suivantes |
|---|---|---|---|
| Incident majeur | Service indisponible pour la plupart des clients | dans les 15 minutes | toutes les 30 minutes |
| Panne partielle | Une fonctionnalité ou une région affectée | dans les 30 minutes | toutes les 60 minutes |
| Problème mineur | Performances dégradées, solution de contournement disponible | dans les 60 minutes | à la résolution |
| Maintenance planifiée | Travaux annoncés avec un impact attendu | plusieurs jours à l’avance | au début et à la fin |
La communication des incidents majeurs inclut aussi votre procédure d’escalade interne : qui est informé à la direction, au support et dans l’équipe commerciale, et à quel moment.
Canaux
- Page de statut : la source de vérité unique pour vos clients
- Notifications aux abonnés : des mises à jour par e-mail ou par chat pour les personnes abonnées
- Avis dans l’application ou sur le site web : une courte bannière qui renvoie vers la page de statut
- Chat et e-mail internes : le canal d’incident pour votre équipe et les parties prenantes
Modèles de communication de panne
Copiez ces modèles et remplacez les éléments entre crochets. Gardez chaque mise à jour courte, factuelle et sereine.
Page de statut : en cours d’analyse
Nous analysons des signalements de [problème] affectant
[service ou fonctionnalité]. Certains utilisateurs peuvent constater
[symptôme]. Notre équipe y travaille, et nous publierons la prochaine
mise à jour d'ici [heure et fuseau horaire].
Page de statut : identifié
Nous avons identifié la cause de [problème] et déployons un correctif.
[Facultatif : solution de contournement.] Prochaine mise à jour d'ici
[heure et fuseau horaire].
Page de statut : surveillance
Un correctif a été appliqué et [service] se rétablit. Nous surveillons
les résultats et confirmerons dès que tout sera entièrement revenu
à la normale.
Page de statut : résolu
[Service] fonctionne de nouveau pleinement depuis [heure et fuseau horaire].
Le problème était dû à [résumé court et non technique]. Nous publierons
un post-mortem d'ici le [date]. Merci de votre patience.
Modèle d’avis de panne IT (interne)
Objet : [Panne] [Système] indisponible depuis [heure de début]

Ce qui est affecté : [système, fonctionnalité, sites]
Qui est affecté : [équipes, clients, régions]
Solution de contournement : [solution ou « aucune pour le moment »]
Responsable de l'incident : [nom], responsable de la communication : [nom]
Page de statut : [lien]
Prochaine mise à jour : [heure]
E-mail client pour un incident majeur
Objet : Incident [service] du [date] : résolu

Bonjour [nom],

Le [date], entre [début] et [fin] [fuseau horaire], [service] a été
[indisponible / partiellement indisponible] pour [clients concernés].
[Ce que les clients ont constaté, en une phrase.]

La cause était [résumé court]. Nous avons résolu l'incident en [action]
et, pour éviter que cela ne se reproduise, nous [amélioration en cours].

Vous pouvez lire le post-mortem complet ici : [lien]. Pour toute question,
répondez à cet e-mail ou contactez [canal de support].

[Nom], [équipe]
Avis de maintenance planifiée
Maintenance planifiée : le [date], de [début] à [fin] [fuseau horaire],
nous allons [décrire les travaux]. Pendant cette période, [impact attendu].
Aucune action n'est requise de votre part. Nous mettrons à jour cet avis
une fois la maintenance terminée.
Exemple de communication d’incident : une chronologie complète
Voici à quoi ressemble un court incident sur une page de statut quand le plan fonctionne :
| Heure | Étape | Mise à jour |
|---|---|---|
| 08:57 | En cours d’analyse | Nous observons des temps de réponse élevés sur l’API et analysons la situation. Prochaine mise à jour d’ici 09:15 CET. |
| 09:02 | Note interne | Pool de connexions à la base de données épuisé : mise à l’échelle des réplicas de lecture. |
| 09:06 | Résolu | Les temps de réponse sont revenus à la normale. Un post-mortem suivra. |
La note interne reste au sein de l’équipe ; les clients ne voient que les mises à jour publiques.
Modèle de post-mortem d’incident
Un post-mortem clôt l’incident. Gardez-le sans recherche de coupable (blameless) : concentrez-vous sur ce qui s’est passé et sur ce que vous allez améliorer, pas sur qui a commis une erreur. Ce modèle de post-mortem d’incident couvre l’essentiel :
Post-mortem d'incident : [titre]
Date : [date]   Sévérité : [niveau]   Auteur : [nom]

1. Résumé
   Ce qui s'est passé, en deux ou trois phrases.

2. Impact
   Durée : de [début] à [fin] ([total])
   Concernés : [services, clients, régions]
   Impact sur le SLA : [oui/non, détails]

3. Chronologie (avec fuseau horaire)
   [heure] Détecté par [moniteur / signalement]
   [heure] Incident ouvert, première mise à jour publiée
   [heure] Cause identifiée
   [heure] Correctif déployé
   [heure] Résolu et confirmé

4. Cause racine
   Ce qui a causé l'incident, et pourquoi c'était possible.

5. Ce qui a bien fonctionné
   Détection, réponse et communication qui ont fonctionné.

6. Améliorations
   [action] — responsable : [nom] — échéance : [date]
   [action] — responsable : [nom] — échéance : [date]

7. Récapitulatif de la communication
   Mises à jour de la page de statut : [nombre], abonnés notifiés : [oui/non]
Outils de communication d’incident
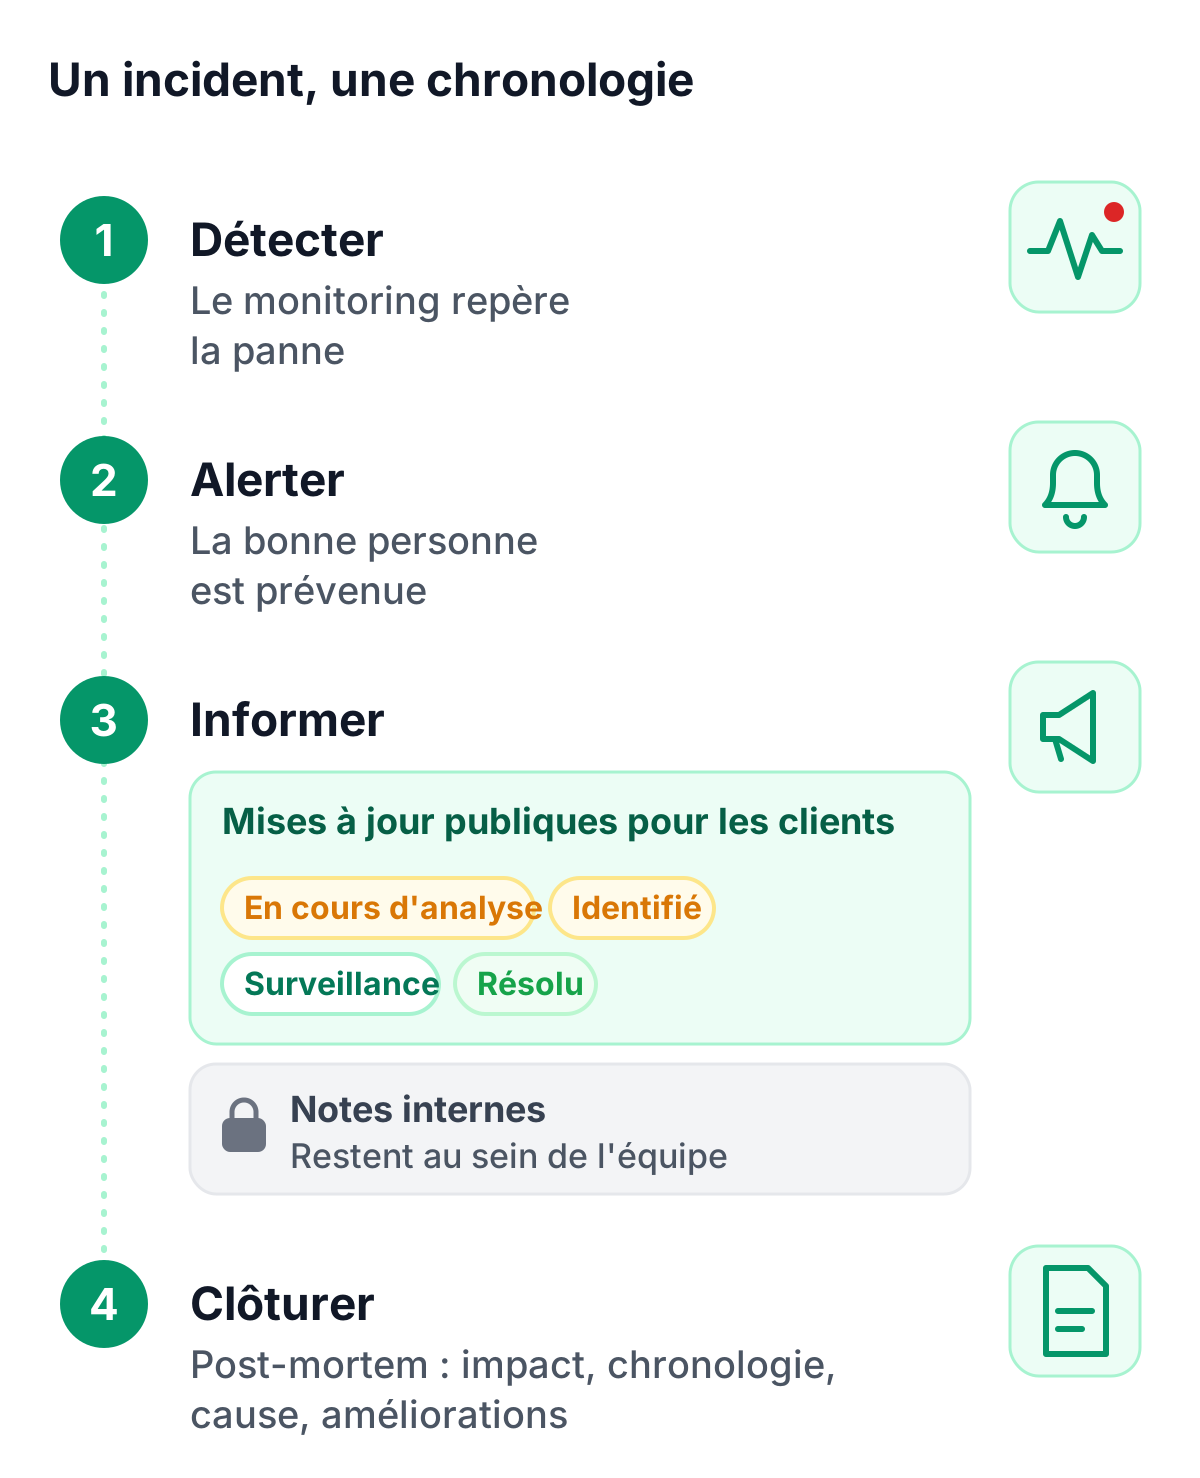
Les outils de communication pour la gestion des incidents donnent le meilleur d’eux-mêmes lorsqu’ils sont connectés et partagent une seule chronologie : un monitoring qui détecte le problème, des alertes qui atteignent la bonne personne et une page de statut qui informe les clients. Ainsi, personne ne recopie d’informations d’un outil à l’autre pendant que l’incident est encore en cours.
Comment TrustComponent Monitoring soutient votre plan
TrustComponent Monitoring réunit ces éléments sur une seule plateforme européenne :
- Détection et alertes : des vérifications jusqu’à toutes les 30 secondes, des alertes sur 16 canaux, des chaînes d’escalade jusqu’à 20 étapes et l’acquittement en un clic
- Brouillons d’incidents : lorsqu’un service surveillé subit une panne, un brouillon d’incident prérempli est prêt, mais rien n’est publié sans votre décision
- Une chronologie, deux publics : des mises à jour publiques pour les clients et des notes internes pour votre équipe, avec pièces jointes
- Quatre catégories : incidents, maintenances planifiées, avis d’information et événements de sécurité
- Post-mortems et export : clôturez les incidents avec un post-mortem structuré et exportez le dossier complet en PDF/ZIP
- Abonnés : les mises à jour parviennent automatiquement aux abonnés, à votre marque et dans la langue de votre page de statut
Découvrez toutes les fonctionnalités de gestion des incidents.
Conclusion
Les incidents arrivent ; un plan rend la communication qui les entoure sereine et cohérente. Définissez les rôles et les niveaux de sévérité, préparez vos modèles et clôturez chaque incident majeur par un post-mortem. Vos clients se souviendront d’une équipe qui les a tenus informés.
Pour commencer
👉 Essayez TrustComponent Monitoring gratuitement et réunissez votre monitoring, vos incidents et votre page de statut au même endroit.